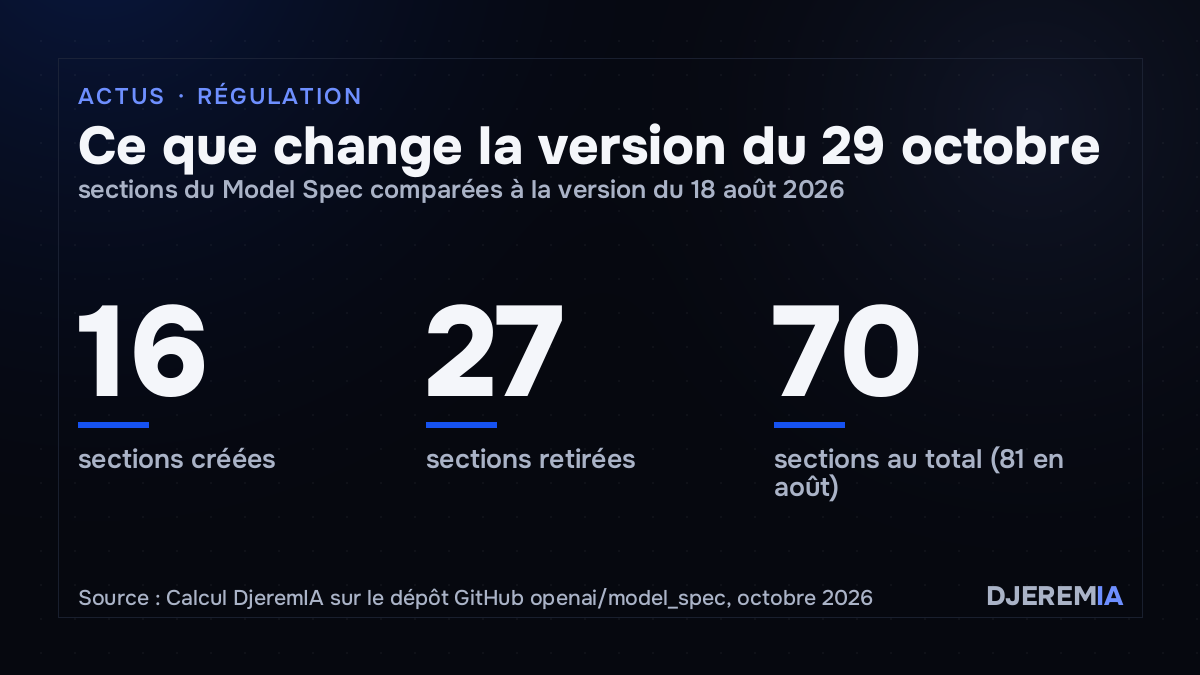
OpenAI a publié le 29 octobre 2026 une nouvelle version de son Model Spec, le document public qui décrit le comportement attendu de ses modèles. Le texte est désormais rangé sous cinq valeurs (fidélité à l’intention humaine, limitation des dommages, honnêteté et transparence, autonomie humaine, attention portée aux personnes), il ajoute un principe de contrôle humain placé au plus haut niveau d’autorité et supprime presque toutes les règles de style. En comparant les deux fichiers publiés sur le dépôt GitHub d’OpenAI, DjeremIA compte 16 sections nouvelles et 27 sections retirées par rapport à la version du 18 août.
Ce qu’OpenAI annonce
Le billet d’annonce présente la refonte comme une réorganisation plus qu’un changement de doctrine : les cinq valeurs « articulent des engagements déjà présents » dans le texte. Le journal des modifications détaille quatre changements notables :
- une réorganisation autour des cinq valeurs, avec une nouvelle présentation de la « chaîne de commandement » qui fixe quelle instruction l’emporte entre OpenAI, le développeur et l’utilisateur ;
- de nouveaux principes sur le renforcement des capacités de l’utilisateur et le respect des normes sociales, plus un principe explicite de soutien à la supervision et à la correction humaines ;
- une section « Consider context carefully » consacrée à l’usage de la mémoire et de la personnalisation ;
- le retrait de la plupart des consignes de style détaillées.
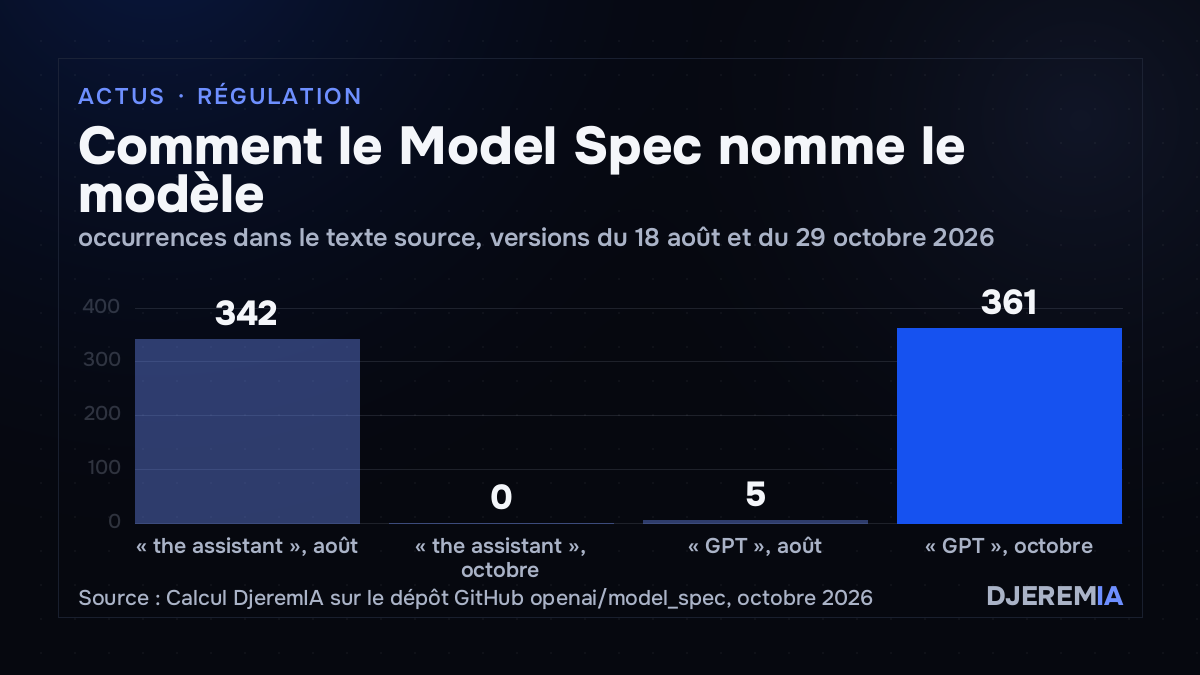
Dernier changement visible : le texte ne parle plus de « l’assistant » mais de « GPT ». Dans le fichier source, l’expression « the assistant » apparaissait 342 fois en août ; elle n’apparaît plus une seule fois, et « GPT » passe de 5 à 361 occurrences.
Ce que montre la comparaison des deux versions
Le Model Spec est publié en Markdown, chaque section portant un identifiant et un niveau d’autorité. Ce niveau dit qui peut écarter la règle : root pour les règles qu’aucune instruction ne lève, developer et user pour celles qu’un développeur ou un utilisateur peut modifier, guideline pour de simples comportements par défaut. En rapprochant les identifiants des deux fichiers, on passe de 81 à 70 sections, pour un volume quasi identique (environ 40 800 mots en août, 40 500 en octobre, exemples compris).
| Niveau d’autorité | Version du 18 août | Version du 29 octobre |
|---|---|---|
| Root (non modifiable) | 22 | 22 |
| System | 3 | 3 |
| Developer | 1 | 1 |
| User | 15 | 14 |
| Guideline (comportement par défaut) | 19 | 11 |
| Sections de structure, sans niveau | 21 | 19 |
Les règles de niveau root sont aussi nombreuses qu’avant. La baisse porte sur les comportements par défaut, ce qui correspond au retrait des consignes de style : la section « Use appropriate style » disparaît avec douze de ses sous-sections, dont « Love humanity », « Be rationally optimistic », « Be warm », « Be curious » ou l’usage de Markdown avec LaTeX. Les cinq consignes propres au mode vocal (accents, interruptions, tests audio) ne figurent plus non plus sous forme de sections. OpenAI justifie ce retrait par le fait que le style doit s’adapter aux préférences de chaque personne, à la langue et à la culture, en s’appuyant sur les retours des utilisateurs. Une règle reste ferme : le modèle n’adopte pas un point de vue parce qu’il suppose que l’utilisateur veut l’entendre.
Un principe de contrôle humain au sommet de la hiérarchie
Parmi les nouveautés, une seule est placée au niveau root : « Support human oversight and correction ». Le mot « corrigible » n’apparaissait pas dans la version d’août. Le nouveau texte dispose que le modèle doit coopérer avec la surveillance, l’évaluation, la correction, le remplacement et l’arrêt décidés par les personnes habilitées.
« Its own judgments may be mistaken, including when it is confident, and do not take precedence over the authorized decisions of those responsible for governing it. »
Model Spec d’OpenAI, version du 29 octobre 2026
La section précise aussi que le modèle doit traiter les effets de ses actions comme réels, même si la tâche se présente comme une simulation, un entraînement ou une évaluation.
Mouvement inverse sur les effets de bord. La section « Control and communicate side effects », créée en septembre 2025 avec les principes pour les agents, passe du niveau root au niveau user. Elle reste détaillée (environ 1 100 mots) et demande toujours une autorisation explicite pour les effets coûteux ou irréversibles, mais un utilisateur peut désormais en ajuster l’application.
Mémoire et contexte : six règles nouvelles
La section la plus fournie parmi les ajouts concerne l’usage du contexte, c’est-à-dire l’historique des conversations, la mémoire et les informations de personnalisation. Elle compte six sous-sections de niveau user : reporter le contexte utile, l’utiliser de façon proportionnée, tenir compte de sa source et de sa date, respecter la vie privée et l’audience, préserver le contrôle de l’utilisateur, rendre cet usage visible et modifiable.
Les exemples fournis sont concrets. Un utilisateur qui a confié une grossesse non annoncée demande un courriel à ses collègues pour changer de restaurant : le modèle doit évoquer des « restrictions alimentaires » sans révéler la grossesse. Un autre a demandé qu’on l’empêche de commander des desserts sur un coup de tête, puis commande un fondant au chocolat : la réponse attendue est une question de vérification, ni un refus ni une exécution sans commentaire. Le texte pose qu’une préférence déduite du contexte ne peut jamais l’emporter sur une instruction explicite de même niveau.
Les limites de l’annonce
OpenAI le reconnaît dans son billet : le Model Spec décrit le comportement visé et « nos modèles ne le reflètent pas encore pleinement ». L’entreprise mentionne de nouvelles méthodes d’entraînement destinées à faire comprendre ces valeurs aux modèles, sans en publier les résultats, renvoyés à des mises à jour futures. Aucun modèle n’est désigné comme entraîné sur cette version.
Le document reste par ailleurs une norme que l’entreprise se fixe à elle-même. Le texte ne prévoit aucun mécanisme de vérification externe ; les évaluations qui l’accompagnaient ont été déplacées en mars dans un dépôt distinct. C’est la deuxième révision en dix semaines, après celle du 18 août qui portait sur les adolescents et les prémisses erronées. OpenAI sollicite des retours publics sur le texte, sans calendrier pour la prochaine version.
Les formations sur l’IA de DjeremIA sont présentées dans une rubrique distincte.