Anthropic a publié le 2 novembre 2026 FlashProve, un prototype de recherche qui permet à un fournisseur d’IA de prouver qu’une réponse sort bien du modèle qu’il annonce, sans dévoiler les poids de ce modèle. La démonstration ne porte pas sur Claude mais sur Llama 4 Maverick, le modèle ouvert de Meta. Le code est sous licence Apache 2.0, et Anthropic le présente comme un « progrès intermédiaire » plutôt que comme un produit.
Le problème : rien ne garantit quel modèle a répondu
Quand une application interroge un modèle par une API, elle reçoit du texte et rien d’autre. Le billet de recherche d’Anthropic, signé par l’équipe Frontier Red Team avec des chercheurs de l’EPFL, du MIT, de StarkWare et de Succinct, part de ce constat : un utilisateur ne peut pas vérifier que la réponse provient du modèle précis que le fournisseur prétend servir. Un service peut substituer une version quantifiée, moins chère, ou un autre modèle, sans que le client le voie.
Le billet cite quatre usages. Un régulateur pourrait exiger la preuve qu’un parc de processeurs graphiques sert de l’inférence et non l’entraînement d’un nouveau modèle, ce qui permettrait de contrôler des quotas de calcul. Une entreprise pourrait vérifier que ses serveurs, éventuellement compromis, font tourner les poids attendus. Un utilisateur pourrait s’assurer qu’une réponse vient du modèle de pointe facturé et non d’une version dégradée. Enfin, une autorité pourrait imposer que seuls des modèles approuvés soient servis.
Un engagement, une preuve, une vérification
FlashProve repose sur un zkSNARK, une preuve à divulgation nulle de connaissance : un calcul est certifié correct par un court certificat qui ne révèle rien d’autre. Le dépôt GitHub décrit trois étapes :
- Engagement. Le fournisseur publie un identifiant qui le lie à un jeu de poids précis, lesquels restent secrets. L’opération prend environ 39 minutes par modèle.
- Preuve. Pour chaque requête, le processeur graphique du fournisseur produit une preuve que la sortie est celle du modèle engagé.
- Vérification. N’importe qui contrôle la preuve sur un processeur ordinaire, sans les poids, avec le programme
cp_verify. Le client télécharge 6,24 Mo une fois par engagement.
La solidité du protocole est démontrée dans l’assistant de preuve Lean 4 : un fournisseur qui ferait passer une autre sortie pour celle du modèle engagé n’est pas détecté qu’avec une probabilité infime, que le dépôt chiffre à q/2124 + 2-101 après q appels à la fonction de hachage. Le billet justifie ce recours à la vérification formelle par une phrase sur ses propres outils : « Claude is good at optimization, but often makes decisions that are hard to evaluate. » La spécification du protocole est d’ailleurs présentée comme rédigée par Claude.
Ce que mesurent les essais
Les mesures portent sur Llama 4 Maverick dans une conversion publique en 4 bits : 400 milliards de paramètres, dont environ 17 milliards actifs par jeton, sur un seul H100 de 80 Go, 24 cœurs de processeur et des requêtes de 1 024 jetons. La page performance du dépôt donne le débit selon le nombre de requêtes prouvées ensemble.
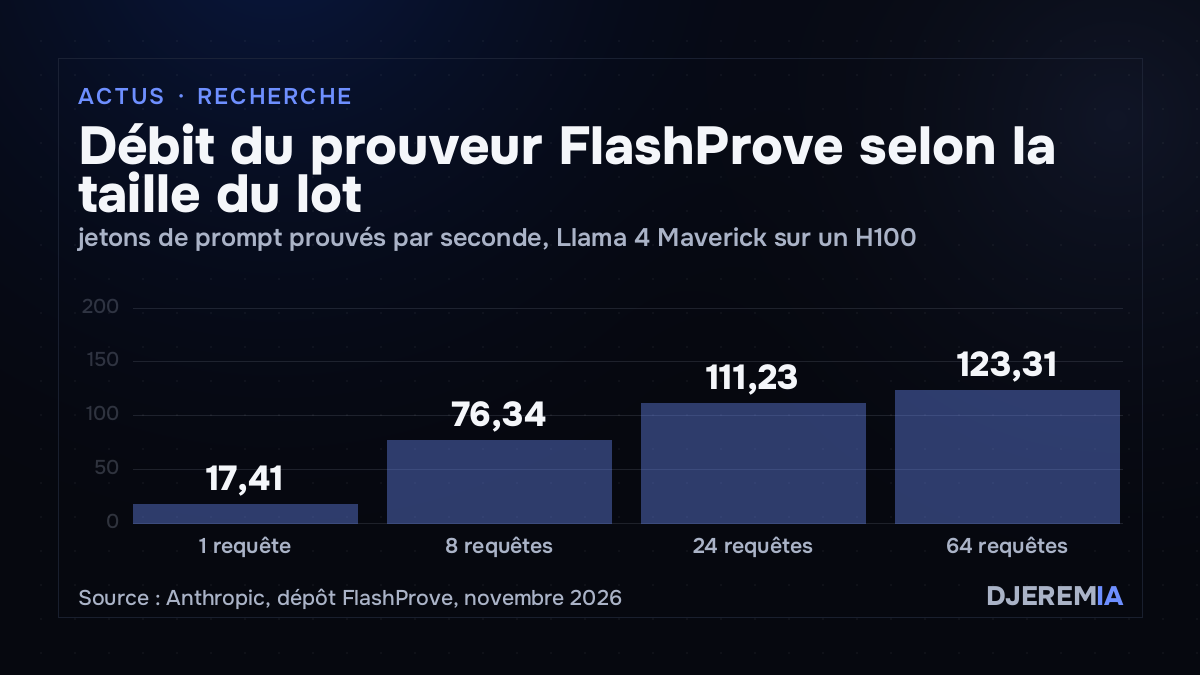
Le chiffre de 110 jetons par seconde mis en avant par Anthropic correspond à un lot de 24 requêtes. Il faut le lire avec sa définition : ce sont des jetons de prompt traités, chaque preuve attestant le jeton suivant. Quand chaque jeton d’une réponse déjà écrite est vérifié, le dépôt mesure 39,1 jetons de réponse par seconde. En lot de 24, une requête attend aussi toute sa fournée, soit 220 à 226 secondes entre le début du lot et la sortie des preuves.
| Indicateur | Valeur mesurée | Conditions |
|---|---|---|
| Débit du prouveur | 111,23 jetons/s | lot de 24 requêtes, jetons de prompt |
| Débit sur réponses complètes | 39,1 jetons de réponse/s | réponses stockées de 31 à 500 jetons |
| Taille d’une preuve | 18,78 Mo en moyenne | par requête |
| Vérification | environ 21 s sur un fil | processeur seul, sans GPU |
| Surcoût face à vLLM | 71,4 à 93,0 fois plus lent | par GPU, vLLM en FP8 sur huit H100 |
| Mémoire du serveur | 269,7 Go | service en lot de 24 |
Un saut de vitesse, un coût encore lourd
Le billet compare FlashProve aux travaux antérieurs. Le seul autre système publié capable de prouver Llama 4 Maverick, VerInf, tournait à environ 0,02 jeton par seconde. Pour 1 000 jetons, la preuve passe de 14,3 heures à 9 secondes, et sa taille de 93,6 Go à 19 Mo. Anthropic en tire une accélération d’environ 5 500 fois.
Le coût reste élevé au regard de l’inférence ordinaire. Selon le calcul du dépôt, au plus fort de la charge, il faudrait 93 processeurs graphiques de preuve pour suivre ce qu’un seul GPU de vLLM ingère en prompt. Le dépôt précise que ce ratio est un cas favorable, puisque le démarrage et l’engagement ne sont pas comptés.
Les limites posées par les auteurs
Le dépôt est explicite sur ce que le système ne fait pas encore :
- Un modèle entier, en décodage glouton. La preuve porte sur une version en entiers du modèle, qui choisit toujours le jeton le plus probable. Sur 96 réponses produites par vLLM en 16 bits et en FP8, aucune ne correspondait exactement à ce modèle entier. Il faut un greffon de vLLM qui calcule ce modèle à l’identique : 48 réponses courtes sur 48 ont alors été prouvées, à 0,58 à 1,46 seconde par jeton.
- Un contexte de 1 024 jetons. Les modèles de pointe travaillent sur des centaines de milliers de jetons.
- Une seule architecture. Le système vise les modèles à mélange d’experts, et l’architecture elle-même n’est pas masquée.
- Des canaux auxiliaires hors périmètre. Le temps de calcul ou la consommation électrique pourraient trahir des informations sur les poids.
- Un écart entre preuve formelle et code rapide. Seul le vérificateur écrit en Lean est prouvé correct ; le vérificateur C++ utilisé en pratique ne l’est pas.
Le dépôt, créé le 30 octobre, se déclare « not maintained » et n’accepte pas de contributions. Ni le billet ni le dépôt n’annoncent d’application aux modèles Claude ou à l’API d’Anthropic. Le travail est publié pour être repris : le billet dit vouloir que d’autres équipes l’examinent, l’adaptent et l’améliorent.
L’audit et cadrage IA de DjeremIA dispose d’une présentation distincte.