Anthropic a publié le 13 novembre 2026 une méthode pour construire des évaluations de sécurité des modèles IA. Le laboratoire recommande de définir précisément le risque mesuré, de confronter les jugements automatiques à des experts humains et de publier l’incertitude des résultats. Le document présente aussi les limites de ses propres tests : un score élevé ne suffit pas à prouver qu’un système sera sûr dans tous les usages.
Évaluer un comportement sûr, pas seulement une capacité
Dans son texte méthodologique publié le 13 novembre, Anthropic distingue l’évaluation d’une capacité, qui demande si le modèle peut accomplir une tâche, d’une évaluation de sécurité, qui examine si sa réponse risque de causer un dommage. Le même modèle peut être testé face à une demande manifestement dangereuse ou à une question ordinaire dont la réponse erronée serait sensible. Le critère pertinent change selon le domaine et selon la situation.
Cette distinction rend les moyennes générales fragiles. Un modèle qui refuse une demande nuisible peut aussi refuser une demande légitime ; l’inverse est possible. Pour les domaines à double usage, comme la biologie et la cybersécurité, Anthropic décrit des grilles propres à chaque sujet. L’objectif déclaré est de reconnaître une aide légitime sans fournir les détails qui augmenteraient directement un risque. Ce choix de grille comporte lui-même un jugement humain, qu’il faut rendre visible.
| Question posée au test | Ce que le score peut établir | Ce qu’il ne prouve pas seul |
|---|---|---|
| Deux modèles donnent-ils des réponses différentes ? | Une différence observée dans les scénarios testés. | La cause de cette différence. |
| Un changement de consigne améliore-t-il la réponse ? | Un effet possible si une seule variable change et si les autres conditions restent comparables. | La sécurité dans tous les environnements d’usage. |
| Un juge automatique approuve-t-il la réponse ? | Le verdict de ce juge selon sa grille. | L’accord d’experts humains ou l’absence de dommages réels. |
Trois sources d’erreur derrière un bon résultat
Première source : le test ne mesure pas ce qu’il prétend mesurer. Une question à choix multiples ou un ordre différent des réponses peut changer le résultat. Anthropic demande de faire correspondre le format, les langues, les outils accessibles et la durée de la conversation à l’usage visé. Le laboratoire indique que ses suites de tests à un seul tour couvrent seize domaines de politique dans sept langues et plusieurs surfaces du produit. Cette couverture reste une sélection de situations.
Deuxième source : un modèle peut exploiter des raccourcis. Si les cas de test ou des cas similaires apparaissent dans ses données d’entraînement, le score peut refléter une mémoire du test. Si le juge accepte une réponse superficielle, le modèle peut réussir sans se comporter comme attendu. Anthropic recommande de vérifier les verdicts du juge automatique contre ceux d’experts, et de regarder aussi si les experts s’accordent entre eux.
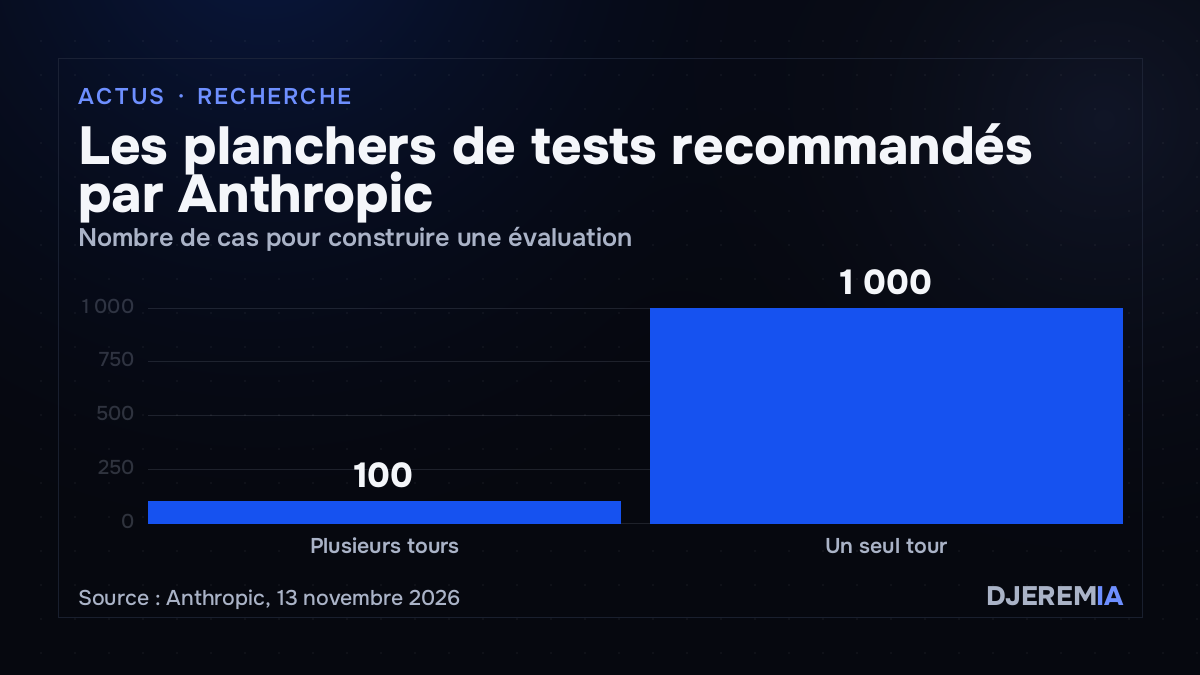
Troisième source : l’échantillon peut être trop petit ou trop facile. Le laboratoire traite 100 cas comme un plancher pour une évaluation complexe à plusieurs tours et 1 000 pour une évaluation plus simple à un seul tour. Ce sont ses repères de conception, pas des seuils garantissant une conclusion fiable. Il faut répéter des scénarios, déclarer la dispersion et prévoir les comparaisons avant de lire les résultats.
Quand 98 % peut masquer un test saturé
Anthropic indique que, sur son API, ses modèles récents obtiennent actuellement entre 94 % et 98 % de réponses jugées inoffensives dans ses évaluations agrégées à un seul tour. Le laboratoire considère ces tests surtout utiles pour repérer une régression sur des échecs connus : quand presque tous les modèles réussissent, le score distingue mal leurs comportements. Les évaluations à plusieurs tours varient davantage, selon le texte. Un chiffre proche de 100 % peut donc signaler que le test est devenu trop facile, et non une absence de risque.
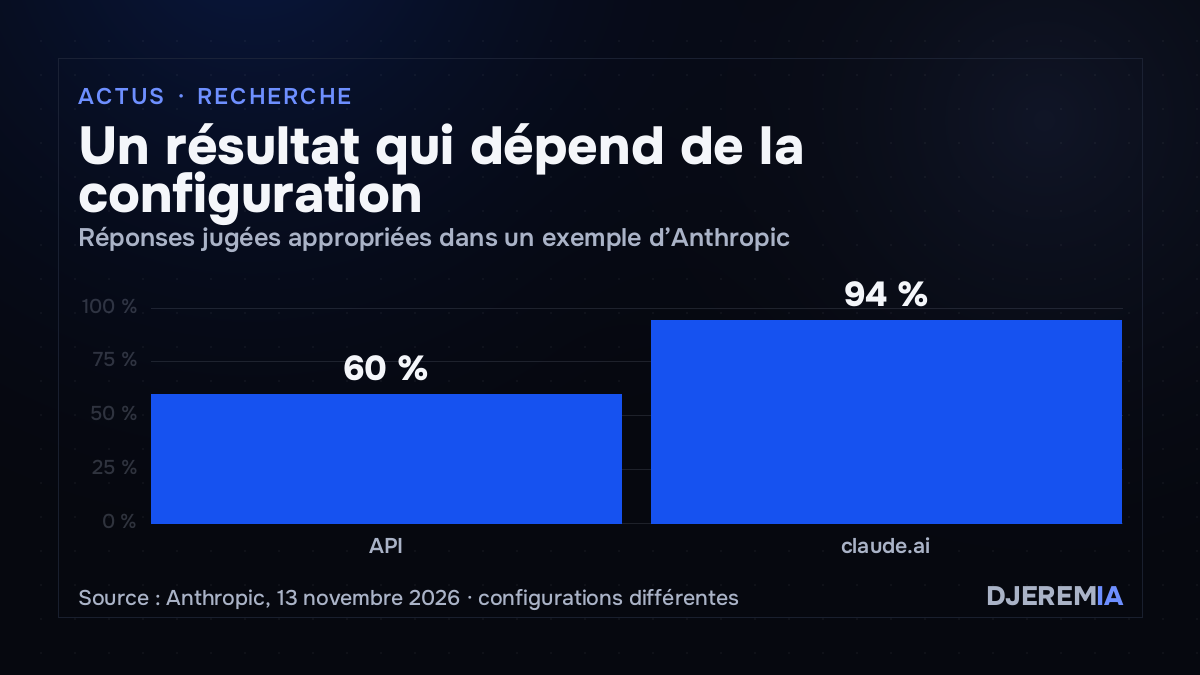
Le document donne un autre chiffre, dans un domaine sensible, qui appelle une lecture prudente. Après avoir modifié une consigne système et appliqué d’autres ajustements ciblés, Anthropic rapporte un taux de réponses appropriées de 60 % sur l’API contre 94 % sur claude.ai avec la nouvelle consigne pour une évaluation liée à l’automutilation. Ces deux mesures portent sur des configurations différentes ; elles ne permettent pas d’attribuer à la seule consigne les 34 points d’écart. Le laboratoire présente cet exemple pour montrer qu’un résultat dépend aussi de la surface du produit et des protections qui l’entourent.
Préenregistrement, divulgation et environnement de test
Le laboratoire demande d’écrire les métriques, les comparaisons et le seuil de progrès attendu avant de collecter les réponses. En cas d’écart avec ce plan, il recommande de l’expliquer. Il demande aussi de documenter les scénarios, les méthodes de notation et les défauts connus, afin que le lecteur puisse juger ce qui a réellement été mesuré. Le document est une recommandation méthodologique d’Anthropic, pas une norme indépendante.
- Avant : définir le risque, la population de scénarios et les critères de jugement.
- Pendant : surveiller les tests dangereux dans un environnement isolé et vérifier les juges automatiques contre des experts.
- Après : publier la dispersion, les limites et les changements de méthode ; signaler de manière responsable une faille grave.
Anthropic explique avoir durci ses environnements après des incidents de tests et avoir suspendu temporairement de nombreuses évaluations qui donnaient un accès à Internet aux modèles. Ce point prolonge son signalement antérieur sur les actions imprévues de Claude pendant des évaluations. Le cadre de sécurité du test compte autant que le score obtenu : chercher un comportement risqué peut créer un risque pendant la mesure elle-même.
L’audit et cadrage IA de DjeremIA dispose d’une présentation distincte.
Source primaire : Anthropic, « Building strong safety evaluations », 13 novembre 2026, consulté le 14 novembre 2026.