Flower Labs lance Endeavor 1.0 avec une promesse rare : les performances d’un modèle frontier, sans t’obliger à louer éternellement ton intelligence à une API fermée. Pour un builder solo, l’idée est séduisante. Mais aujourd’hui, Endeavor est encore une preview sur invitation, et les performances publiées viennent de Flower. La bonne lecture n’est donc pas « un nouveau champion est arrivé ». C’est plutôt : le déploiement privé commence enfin à viser le haut du tableau.
Le vrai produit, ce n’est pas seulement le modèle
Dans son annonce du 1er septembre, Flower présente Endeavor comme un généraliste conçu pour le raisonnement, le code et les agents qui travaillent sur des tâches longues. Le modèle peut être consommé comme un service géré par Flower, ou déployé dans l’infrastructure d’une organisation.
Ce deuxième mode est le point intéressant. Quand tu construis un produit autour d’un modèle fermé, tu n’accumules pas seulement des prompts. Tu ajoutes des évaluations, des outils, des règles, des données, des garde-fous et des boucles de retour. Plus ce système mûrit, plus changer de fournisseur devient coûteux.
Flower vend donc moins un simple endpoint qu’une porte de sortie : commencer avec un service managé, puis déplacer certains usages sensibles — ou l’ensemble du système — vers une infrastructure privée. Pour une petite équipe, ce n’est pas un besoin immédiat. Pour un produit qui traite des données clients ou dont la marge dépend fortement du coût des tokens, c’est une option stratégique.
Le verrouillage ne commence pas quand ton fournisseur augmente ses prix. Il commence quand tout ton produit apprend à dépendre de lui.
Les benchmarks sont impressionnants, pas encore une preuve
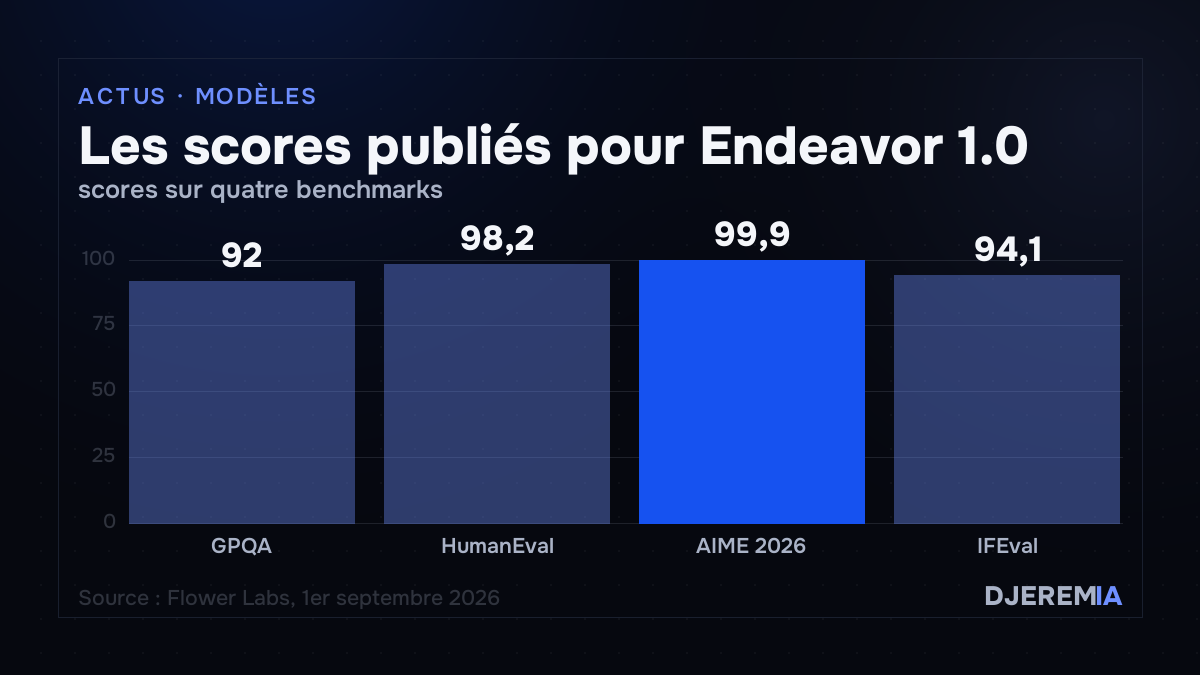
Flower annonce un score de 92,0 sur GPQA, 98,2 sur HumanEval, 99,9 sur AIME 2026 et 94,1 sur IFEval. Dans le tableau publié par l’entreprise, Endeavor obtient le meilleur résultat HumanEval face à GPT-5.6 Sol, Claude Fable 5, Kimi K3 et Nemotron 3 Ultra. Il égale aussi GPT-5.6 Sol et Claude Fable 5 sur AIME 2026.
Ces chiffres placent Endeavor dans la conversation. Ils ne permettent pas encore de conclure qu’il est meilleur dans ton workflow. Quatre benchmarks couvrent mal les tâches où un agent doit utiliser plusieurs outils, résister à une instruction ambiguë, reprendre après un échec et produire un résultat exploitable pendant plusieurs heures.
Il faut aussi garder une règle simple : un tableau publié au lancement est une affirmation de l’éditeur, pas une validation indépendante. Flower reconnaît d’ailleurs qu’un petit ensemble de benchmarks ne décrit pas l’utilité réelle d’un modèle. La nuance est bienvenue, mais elle ne remplace pas des tests externes reproductibles.
Le déploiement privé reste un avantage théorique pour beaucoup
« Déployable chez toi » sonne comme une liberté immédiate. En pratique, Flower ne publie dans son annonce ni les poids en téléchargement libre, ni le prix, ni les besoins matériels du modèle. L’accès se fait sur demande et l’entreprise sélectionne d’abord un nombre limité d’organisations et de partenaires.
Autrement dit, Endeavor n’est pas encore le modèle que tu installes ce soir sur une machine à 2 000 euros. Le déploiement privé vise probablement des structures capables de financer du calcul, de l’intégration et de l’exploitation. Pour un builder solo, la valeur immédiate sera plutôt dans l’existence d’une alternative commerciale : un fournisseur peut gérer le modèle aujourd’hui tout en laissant une trajectoire vers davantage de contrôle demain.
Cette distinction compte. « Privé » ne veut pas dire « simple », « bon marché » ou « open source ». Cela veut dire que l’organisation peut choisir où tourne le système et où restent ses données. C’est déjà important, mais ce n’est pas la même promesse.
Ce que tu peux changer dans ton architecture dès maintenant
Tu n’as pas besoin d’attendre Endeavor pour réduire ta dépendance. Commence par isoler l’appel au modèle derrière une couche simple, conserve tes évaluations hors du fournisseur et évite d’enfouir toute ta logique dans des fonctions propriétaires. Si ton application peut comparer deux modèles sur les mêmes tâches, tu gardes un levier de négociation — et une solution de secours.
Endeavor mérite ensuite un test lorsque l’accès s’élargira, surtout sur trois critères : la qualité réelle des agents longs, le coût total du service managé et les ressources nécessaires au déploiement privé. Les scores de code sont utiles, mais le test décisif sera plus banal : est-ce que le modèle termine une vraie mission sans multiplier les corrections humaines ?
Ma lecture : Flower attaque le bon problème. La prochaine bataille des modèles ne portera pas seulement sur quelques points de benchmark, mais sur la capacité à conserver le contrôle de ce qu’on construit autour d’eux. Endeavor 1.0 n’a pas encore prouvé qu’il gagne cette bataille. Il montre en revanche qu’un acteur crédible pense que le marché est prêt à payer pour ne plus choisir entre puissance et autonomie.
Pour passer de l’actualité à l’usage concret dans ton travail, la formation pour apprendre à faire travailler l’IA commence par une partie gratuite complète.