Anthropic a publié Claude Opus 5.5 le 22 septembre 2026. Le modèle atteint ou dépasse les performances de Fable 5.1 sur la majorité des benchmarks, pour un coût global réduit de 40 % par rapport à Claude Opus 5.
Des performances qui dépassent Fable 5.1 sur plusieurs benchmarks
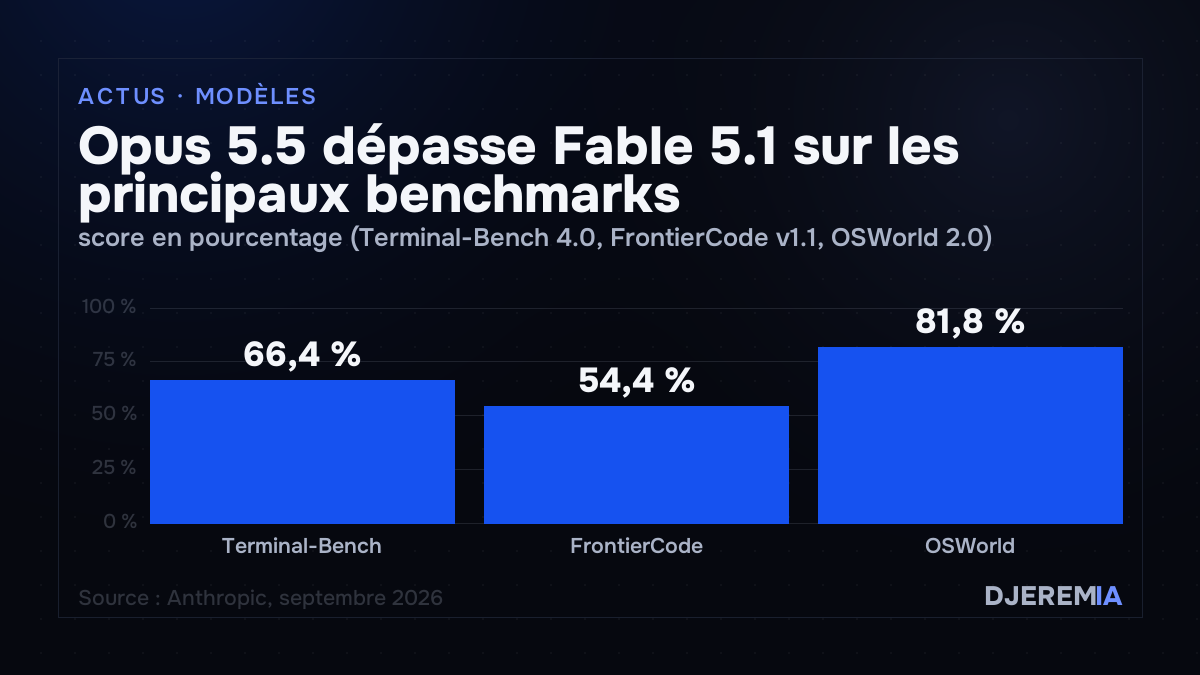
Anthropic positionne Opus 5.5 comme son modèle le plus performant à ce jour, devant Fable 5.1 sur les tâches de code et d’agents :
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 |
|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 % | 55,8 % | 52,3 % |
| FrontierCode v1.1 | 54,4 % | 50,3 % | 48,0 % |
| CursorBench 4.0 | 57,8 % | 51,8 % | 46,6 % |
| OSWorld 2.0 | 81,8 % | 80,7 % | 74,0 % |
| Humanity’s Last Exam | 67,7 % | 65,6 % | 63,6 % |
Sur GDPval-AA v2.1, qui évalue les agents IA en condition réelle, Opus 5.5 atteint un score Elo de 1 846, contre 1 735 pour Fable 5.1 et 1 708 pour Opus 5. Le modèle affiche également un taux de détection de bugs de 72 % contre 56 % pour son prédécesseur, selon les tests internes publiés par Anthropic. Anthropic le présente comme « le modèle le plus performant jamais testé » par la société.
Un mode rapide est disponible, facturé $8/$40 par million de tokens (entrée/sortie), avec une vitesse de génération annoncée jusqu’à 2,5 fois supérieure au mode standard.
Une grille tarifaire revue à la baisse
La réduction de coût de 40 % sur les charges typiques provient d’une baisse simultanée sur les trois postes de facturation :
| Poste | Opus 5.5 | Opus 5 | Variation |
|---|---|---|---|
| Tokens d’entrée | $4 / M | $5 / M | -20 % |
| Tokens de sortie | $20 / M | $25 / M | -20 % |
| Cache reads | $0,20 / M | $0,50 / M | -60 % |
| Cache writes | $5 / M | $6,25 / M | -20 % |
La baisse de 60 % sur les lectures de cache est la plus significative pour les applications qui gèrent de longs contextes répétés, comme les assistants à base de documents ou les agents qui revisitent fréquemment les mêmes instructions système.
Cas d’usage documentés
Anthropic publie plusieurs exemples chiffrés dans l’annonce :
- Migration de 680 000 lignes de code complétée en moins d’une journée.
- Audit de 200 000 lignes en 3 heures, contre 20 heures pour Opus 5.
- Traduction d’un composant HAProxy en Rust en 9,5 heures, contre 12 heures pour Opus 5, pour un coût inférieur de 51 %.
- Optimisation de temps de chargement web : 39 réussites sur 40 contre des résultats marginaux pour Opus 5.
Anthropic indique également une réduction de 85 % dans les tentatives de contournement de limites, et signale que les performances de sécurité sur les thèmes de la biologie et de la cybersécurité sont comparables au modèle Mythos 5.1, spécialisé sur ces domaines.
Disponibilité
Claude Opus 5.5 est accessible immédiatement via l’identifiant claude-opus-5-5 sur l’API Anthropic, ainsi que sur Amazon Web Services, Google Cloud et Microsoft Azure. Anthropic précise la compatibilité avec la politique de rétention zéro des données pour les cas d’usage sensibles.
La fenêtre de contexte n’est pas précisée dans l’annonce de lancement.
Ce que l’annonce ne dit pas
L’annonce ne fournit pas de données comparatives indépendantes. Les benchmarks cités (Terminal-Bench, FrontierCode, CursorBench, GDPval-AA) sont propres à Anthropic ou à des organisations dans son orbite, ce qui rend la comparaison inter-labs difficile sur ces métriques spécifiques. Humanity’s Last Exam est un repère tiers utilisable pour les comparaisons entre modèles.
L’annonce ne précise pas non plus les conditions exactes des mesures de performance (taille des contextes, configuration des prompts, modalités de test) ni si les gains de vitesse annoncés en mode rapide sont mesurés sur les mêmes tâches que les benchmarks d’intelligence.
Le coût d’Opus 5.5 dans Claude Code, par abonnement ou à l’usage, est détaillé dans le guide des prix de Claude Code.
Quel modèle mettre sur quelle tâche de ton activité, et pour quel coût réel : c’est ce que tranche l’audit et cadrage IA.
Source primaire : Anthropic, 22 septembre 2026.