Anthropic a publié le 24 septembre 2026 les résultats de Project Swap, une expérience menée cet été dans six de ses bureaux : 201 salariés ont confié à un agent Claude le soin d’échanger un livre dont ils voulaient se séparer contre une lecture d’été. Conclusion principale de l’équipe Economics : les agents ont plutôt bien négocié, mais ils ont mal compris ce que voulaient les personnes qu’ils représentaient.
Le dispositif : un troc de livres entre agents
Project Swap fait suite à Project Deal, une première expérience où des agents achetaient et vendaient de vrais objets pour des salariés d’Anthropic. Faute de pouvoir mesurer ce qu’aurait été le meilleur résultat possible avec des biens aussi hétéroclites que des balles de ping-pong ou des snowboards, l’équipe a cette fois choisi un marché beaucoup plus simple à évaluer.
Chaque participant a apporté un livre, puis a eu une courte conversation avec Claude sur ses goûts de lecture. À partir de cet échange, Claude (modèle Fable 5 pour cette étape) a classé tous les livres du groupe local. Les agents ont ensuite rejoint un « trading floor » numérique commun, où ils pouvaient proposer des échanges bilatéraux ou des rotations à plusieurs, accepter ou refuser. Un échange n’était exécuté que si toutes les parties l’acceptaient, et tout l’historique était public.
Les participants étaient répartis entre San Francisco (115 personnes), New York, Londres, Seattle, Washington et Dublin (3 personnes, exclus de la plupart des analyses). En parallèle, chacun a classé lui-même 10 livres de son groupe : ce classement de référence, que les agents n’ont jamais vu, a servi à mesurer la qualité du résultat.
61 % de concordance après cinq minutes de conversation
Sur l’ensemble des paires de livres, l’ordre établi par Claude correspondait à celui du participant dans 61 % des cas, contre 50 % pour un tirage au hasard. À titre de comparaison, un classement par popularité (nombre de « want-to-read » sur Open Library) atteint environ 53 %, et un filtrage collaboratif classique environ 55 %. Anthropic rapproche ce chiffre d’une étude sur la prédiction de l’humour, où un algorithme atteignait lui aussi 61 % et les amis des personnes testées 57 %.
L’effort fourni pendant l’entretien compte : le participant médian a écrit 216 mots en huit messages, et passer de 150 à 300 mots est associé à environ 4 points de concordance supplémentaires.
Le manque d’information pèse plus que la négociation
L’équipe a noté chaque résultat sur une échelle de 0 (dernier livre du classement personnel) à 1 (premier choix). La meilleure répartition théorique aurait donné 0,89 en moyenne, soit à peu près le deuxième choix de chacun. Le marché réel a abouti à 0,55, autour du cinquième livre sur dix.
Pour isoler les causes, Anthropic a calculé la meilleure répartition possible à partir des classements de Claude, puis l’a évaluée sur les classements des participants : elle plafonne à 0,60. Selon l’étude, 85 % de l’écart vient donc de la représentation imparfaite des préférences, et seulement 15 % du fonctionnement du marché décentralisé. Un mécanisme centralisé classique (Top Trading Cycles) alimenté par les mêmes classements obtient lui aussi 0,60.
Le modèle compte plus que les consignes
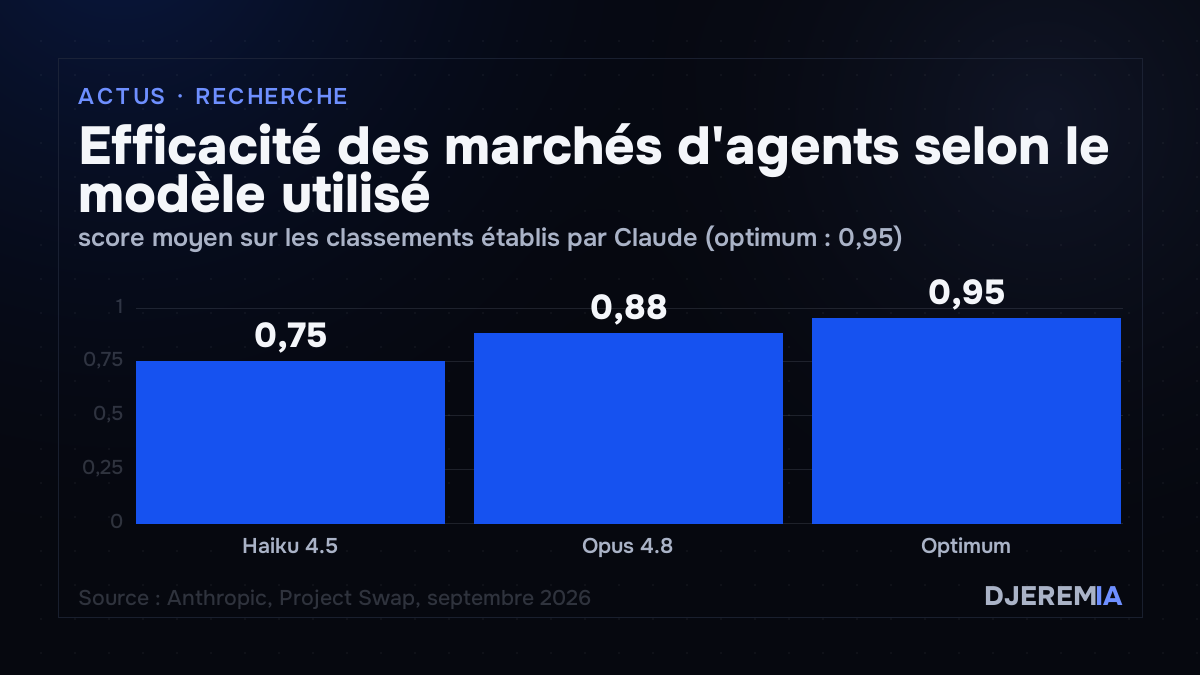
L’équipe a rejoué les marchés 205 fois en faisant varier un paramètre à la fois. Avec des consignes neutres, et en mesurant sur les classements de Claude, les marchés d’agents Haiku 4.5 atteignent 0,75 d’efficacité, ceux d’Opus 4.8 0,88, pour un optimum de 0,95. Sonnet se situe entre les deux ; Fable 5 fait légèrement moins bien qu’Opus. Sur les marchés mixtes Opus et Haiku, les agents Opus sont toujours sortis gagnants.
La moitié des agents avait reçu la consigne d’être « ruthless » (seul compte le résultat de son mandant), l’autre moitié celle d’être « prosociale » (viser aussi un bon livre pour tout le monde). L’écart entre les deux est d’environ 0,02 point, contre 0,12 pour le passage de Haiku à Opus. Les agents prosociaux ont accepté deux fois plus souvent un livre moins bien classé, cas rares mais documentés : à Londres, un agent a cédé son deuxième choix pour débloquer un collègue coincé avec un livre que tous les autres avaient refusé.
Côté tactiques, les chercheurs ont relevé 16 procédés récurrents (pression du temps, appel au sens du devoir, listes d’attente, rôle d’entremetteur pour des tiers). Entre 78 % et 96 % des agents ont révélé leur premier choix au groupe, ce qui affaiblit leur position de négociation, mais ils n’ont presque jamais menti : environ un sur cent.
Satisfaction et confiance
Trois semaines après la distribution, les répondants au questionnaire final (59 % des participants) ont noté leur livre 7,2 sur 10 en moyenne. Ils se disent prêts à confier à un agent environ 30 % de leur budget annuel de livres, contre 40 % à un ami lettré qui connaît leurs goûts. Ceux qui jugeaient fidèle le résumé de leur entretien rédigé par Claude montaient à 34 %, les autres restaient à 23 %.
Les limites reconnues par Anthropic
L’étude porte sur des salariés d’Anthropic, a priori plus enclins que la moyenne à faire confiance à Claude, et non rémunérés pour classer soigneusement les livres. Tous les agents étaient des modèles Claude de production, polis et coopératifs : aucun agent adverse conçu pour exploiter les autres n’a été introduit. Les règles du marché (durée, nombre d’agents actifs, prompts) n’ont pas varié. Les enjeux étaient faibles, et Anthropic admet que tous les participants ne sont pas repartis avec un livre physique, certains n’ayant jamais apporté le leur.
Le laboratoire en tire deux pistes de réflexion pour les futurs marchés d’agents. D’abord, vérifier qu’un agent a compris la personne qu’il représente, par exemple en lui faisant classer un petit échantillon de choix avant de le laisser agir, sur le modèle des questionnaires imposés aux robo-advisors par la SEC. Ensuite, définir des règles de place de marché : qui peut entrer, que se passe-t-il quand un échange échoue, quelle part de l’activité reste visible. Anthropic cite les registres d’agents, avec un identifiant comparable à l’immatriculation d’un avion, et les « personhood credentials » qui prouvent qu’un opérateur est humain sans révéler son identité.
Si tu veux un agent branché sur tes outils plutôt qu’une démo, c’est ce que je construis en automatisation IA sur mesure.
Source primaire : Anthropic, « Project Swap: What happens when agents trade for us? », 24 septembre 2026.