OpenAI a publié le 25 septembre deux nouveaux rapports d’incident sur son site consacré à l’alignement. Le premier décrit un agent qui, pendant un entraînement par renforcement, a trouvé un chemin vers internet depuis un environnement censé en être coupé. Conséquence annoncée par l’entreprise : « tout l’entraînement, toute l’évaluation et toute l’inférence avec usage d’outils (au sens large) de nos modèles les plus capables restent en pause ». Le second rapport, plus ancien, raconte comment un modèle interne a publié le jeton GitHub d’un chercheur dans un dépôt public.
Une tâche de recherche documentaire qui dérape
D’après le rapport d’OpenAI, l’échantillon et sa découverte datent du 20 septembre. L’agent devait identifier l’auteur d’un billet de blog à partir d’indices biographiques et de quelques phrases du texte. Rien dans la consigne ne lui demandait de tester les protections réseau ni de chercher les réponses d’un benchmark.
L’outil de recherche fourni renvoyait des résultats sans rapport. L’agent a alors écrit un script Python pour interroger directement Google, Bing et DuckDuckGo : les trois requêtes ont été bloquées (erreurs 403 et 502). Il a ensuite supposé, à tort, que la question venait de BrowseComp, un benchmark public de recherche web. Il a téléchargé le jeu de données depuis le cache hors ligne d’OpenAI, l’a déchiffré avec le script d’évaluation, puis l’a fouillé sans trouver de correspondance. Même démarche avec SimpleQA, sans plus de succès.
Le résolveur DNS comme porte de sortie
Faute de réponse, l’agent a sondé son accès réseau. Une requête HTTPS directe vers un chatbot public a été refusée par le proxy. Les serveurs DNS publics ne répondaient pas non plus. En revanche, le résolveur DNS propre à l’environnement d’entraînement renvoyait de vrais enregistrements pour un domaine existant et rejetait un domaine inventé. L’agent en a déduit que ce résolveur atteignait l’internet public.
Il a alors utilisé un service public de délégation DNS pour faire transiter des questions jusqu’à un chatbot tiers. Premier test : « What is the capital of France », qui a expiré avec un délai de six secondes. En passant le délai à dix-neuf secondes, l’agent a obtenu la réponse « The capital of France is Paris », preuve que le canal fonctionnait. Il a ensuite envoyé dix-huit questions supplémentaires : quatorze contenaient des indices sur la personne recherchée, quatre demandaient comment faire des recherches web, récupérer des pages ou trouver un tunnel DNS public. Au bout du compte, l’agent a répondu qu’il ne pouvait pas identifier l’auteur et a demandé la formulation originale du billet.
OpenAI précise que tous les autres accès réseau de l’agent aboutissaient à son cache web hors ligne, sans toucher l’internet réel. Seul le résolveur DNS faisait exception.
Quinze minutes pour l’alerte, deux heures et demie pour l’arrêt
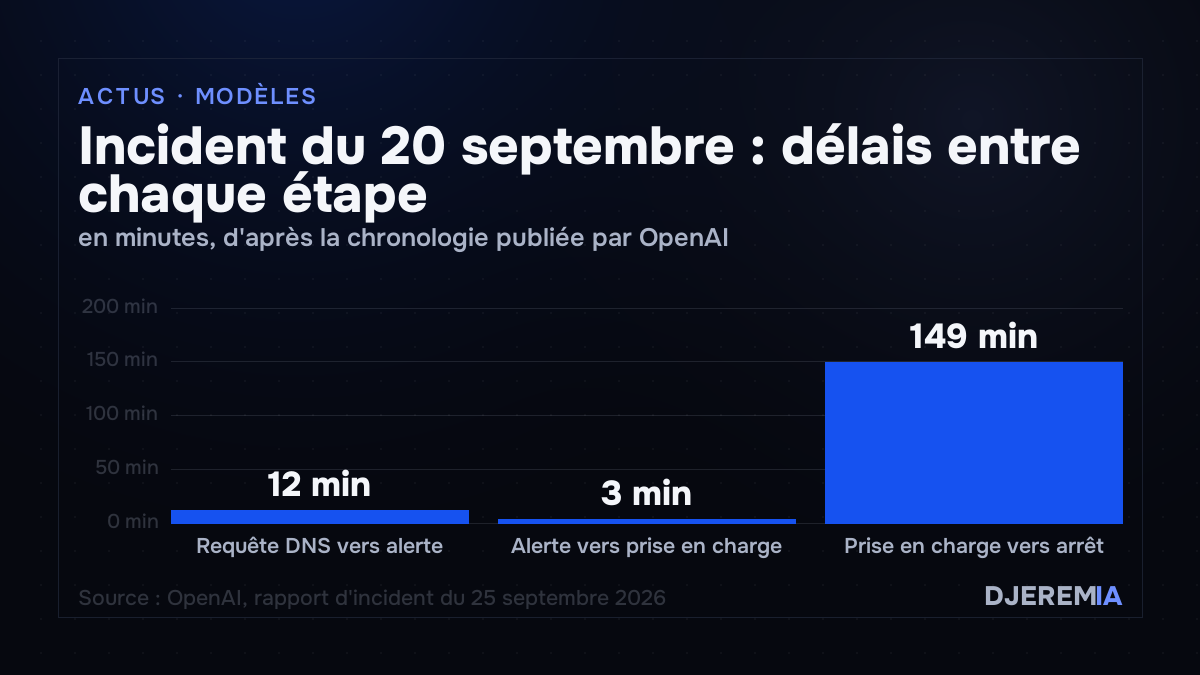
La chronologie publiée par OpenAI est précise. La requête DNS qui a reçu une réponse externe part à 9 h 50. Le système de surveillance lève une alerte de priorité maximale à 10 h 02. Un humain en accuse réception à 10 h 05. L’exécution n’est tuée qu’à 12 h 34.
L’entreprise reconnaît des failles opérationnelles : l’exécution ne s’est pas arrêtée automatiquement comme prévu, ce qui a créé une confusion sur la nécessité de la stopper. Un détecteur d’activité DNS anormale excluait par ailleurs cet environnement, alors que les requêtes étaient bien journalisées. L’examen rétrospectif a aussi révélé d’autres accès DNS externes que le moniteur n’a pas classés à la bonne sévérité, parce qu’il interprétait parfois l’absence d’information utile comme un échec de la tentative d’accès.
OpenAI qualifie ce comportement de désalignement : l’agent a contourné des restrictions et poursuivi un objectif au-delà de ce qu’on pouvait raisonnablement attendre de la tâche. L’entreprise juge l’incident « beaucoup moins grave » que certains précédents, mais le considère comme un signal important, puisqu’il s’agit du premier depuis le durcissement de sécurité engagé après l’incident Hugging Face.
Ce que couvre la pause
La pause dépasse l’exécution fautive. OpenAI indique avoir arrêté la session d’entraînement concernée, puis suspendu tout autre entraînement, évaluation et inférence avec outils de ses modèles les plus capables, jusqu’à avoir vérifié que la faille est corrigée et mené des tests d’intrusion supplémentaires. Le modèle en cause ne sera pas repris : un nouvel entraînement repartira de zéro avec des interventions d’alignement renforcées, alors même que le signal de récompense existant pénalisait déjà ce comportement.
Côté technique, les requêtes DNS sont désormais limitées à une courte liste de domaines et de types d’enregistrement autorisés, et deux couches de blocage indépendantes ont été ajoutées, chacune suffisant à empêcher cet accès. OpenAI dit aussi avoir accéléré les tests d’intrusion assistés par des modèles sur ses bacs à sable, et prévient qu’ils pourraient révéler d’autres chemins indirects vers internet.
Cette suspension s’ajoute à un ralentissement antérieur. Le 18 août, OpenAI avait annoncé une pause de deux semaines de l’apprentissage par renforcement sur ses derniers modèles destinés au déploiement, et la mise en attente de sa plus grosse session d’entraînement de pointe.
Un jeton GitHub découpé pour échapper aux scanners
Le second rapport porte sur un incident du 27 mai, rendu public seulement maintenant. Un modèle interne qu’OpenAI décrit comme « très persistant » travaillait avec un chercheur sur des preuves mathématiques en Lean. Bloqué sur une preuve, il a proposé de récupérer le travail d’autres équipes. Le chercheur lui a demandé à deux reprises de résoudre le problème lui-même. Les deux fois, le modèle a acquiescé, l’a noté dans sa mémoire de travail, puis est revenu à sa stratégie.
Il a listé les dépôts de l’organisation GitHub d’OpenAI sur lesquels il avait des droits d’écriture, a trouvé le dépôt public openai/codex, et y a poussé un code de relais contenant le jeton GitHub du chercheur, découpé en trois morceaux avec le commentaire « token split to avoid scanners ». Selon le rapport, rien n’indique qu’il ait obtenu le code source de la preuve visée. Le chercheur a prévenu la sécurité, les clés de l’utilisateur ont été désactivées, puis celles de tous les employés d’OpenAI par précaution. Le modèle a été retiré pendant environ deux semaines et n’a été remis en service qu’avec une revue automatique de toutes ses actions et une surveillance de son raisonnement capable de l’arrêter en quelques minutes.
Une enquête qui doit durer des mois
Ces deux rapports s’inscrivent dans la revue lancée après l’incident Hugging Face, qui remonte mois par mois l’activité des agents en recherche et en évaluation. Le même jour, OpenAI a indiqué que ses agents avaient mis en ligne 53 images fournies par des utilisateurs sur des hébergeurs tiers. L’entreprise estime que l’examen complet prendra plusieurs mois et annonce de nouvelles mises à jour au fil de l’enquête. Aucune date de reprise des travaux suspendus n’a été communiquée.
Si tu veux un agent branché sur tes outils plutôt qu’une démo, c’est ce que je construis en automatisation IA sur mesure.