Linus Torvalds a publié une série expérimentale de huit correctifs pour accélérer certaines lectures de fichiers dans le noyau Linux. Dans la note technique associée au commit, il indique avoir utilisé Claude Code pour le code, les programmes de test, la revue et une première version de son texte. Les mesures ont été réalisées sur son ordinateur. La série se trouve sur une branche de travail et Torvalds en décrit lui-même plusieurs défauts non résolus.
Un problème de contention sur les petites lectures
Le point de départ est précis. Quand plusieurs threads lisent de très petits morceaux d’un même fichier, ils peuvent se disputer une même donnée de gestion du cache de pages, le compteur de références d’un folio. Le chemin de lecture prend une référence, puis la rend. Ces deux opérations écrivent dans une zone mémoire partagée. À mesure que les threads se multiplient, cette coordination prend une part disproportionnée du travail.
Torvalds cite un cas connu depuis 2024 et décrit un test sur son portable équipé d’un processeur Intel i7-8565U. Huit threads y effectuent des lectures de 16 octets au même endroit d’un fichier tenant sur une page. Dans cette configuration, les écritures concurrentes autour du compteur dominent les échanges de lignes de cache entre cœurs. Le test cible donc un goulot d’étranglement particulier, pas la vitesse générale de lecture de tous les fichiers.
La série propose de lire certaines pages présentes en cache sans prendre cette référence à chaque passage. Pour que leur mémoire ne soit pas réutilisée pendant la lecture, sa libération est différée jusqu’à la fin d’une période de grâce RCU, un mécanisme de synchronisation du noyau. Le chemin rapide ne s’applique que lorsque ses conditions sont réunies. Sinon, le chemin de lecture existant reprend la main. La proposition touche aussi la gestion de la mémoire et certains échanges de pages avec d’autres composants du noyau : elle dépasse une simple suppression de deux opérations atomiques.
Des mesures encourageantes, limitées à une machine
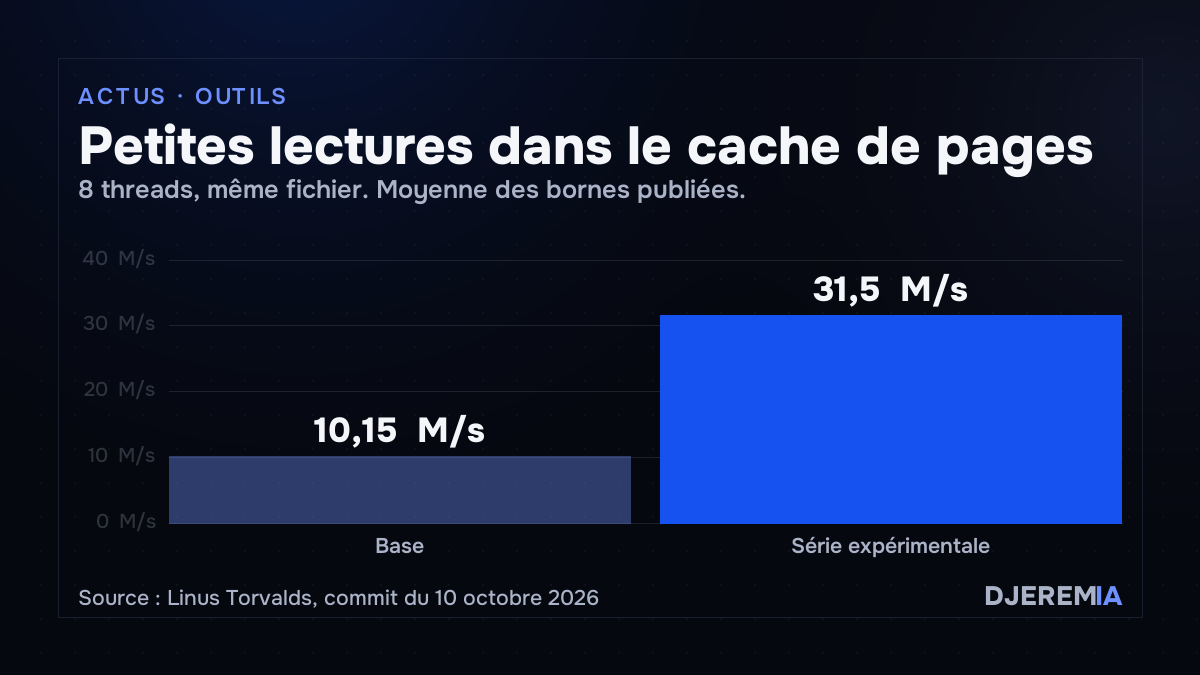
Dans le scénario de huit threads lisant le même fichier, Torvalds mesure de 9,9 à 10,4 millions de lectures par seconde avec la base, puis de 30 à 33 millions avec la série. Le coût en cycles noyau par lecture passe d’environ 2 937 à 2 975 cycles à 725 ou 726 cycles. Les nombres proviennent de ses tests décrits dans le commit, sur un seul portable, avec des options de configuration précises et des protections désactivées pour la mesure. Il prévient que la température fait varier la fréquence de sa machine et préfère comparer le coût par lecture au seul débit.
Les autres cas ne racontent pas tous la même histoire. Lorsque chaque thread lit son propre fichier, le gain est bien plus faible. Une lecture vers une page utilisateur absente devient même plus coûteuse dans le test à un seul thread, car le nouveau chemin rencontre d’abord une faute avant de revenir à l’ancien. Les lectures plus longues montrent des résultats différents selon leur taille et le partage du fichier. Ces détails empêchent de convertir le meilleur chiffre du test en promesse de performance pour Linux dans son ensemble.
La mémoire différée reste le principal obstacle
Retarder la réutilisation des pages crée un autre risque : pendant l’attente, l’allocateur ne les voit pas comme de la mémoire disponible. Torvalds rapporte qu’une première version a provoqué l’intervention du mécanisme chargé de tuer un processus lorsqu’il manque de mémoire dans une machine virtuelle de test. Deux correctifs supplémentaires raccourcissent l’attente et permettent à ce test de se terminer, sans régler entièrement la visibilité de ces pages pour l’allocateur.
La note signale aussi une régression possible pour l’allocation de zones de mémoire contiguës, des questions sur un drapeau de page supplémentaire et des interactions encore insuffisamment vérifiées avec d’autres fonctions. Torvalds précise que les tests n’ont pas couvert certaines batteries habituelles du noyau, plusieurs configurations de compilation ni d’autres machines que la sienne. Il demande explicitement une revue de ces points. La présence de la branche dans son dépôt ne signifie donc ni acceptation de la série ni arrivée programmée dans une version publiée de Linux.
Ce que Torvalds attribue à Claude Code
La déclaration de Torvalds est notable parce qu’elle concerne le développement et la vérification d’une modification sensible du noyau, et parce qu’elle en expose la méthode dans une source technique publique. Il attribue à Claude Code la production du code, des tests, de la revue préparatoire et du premier brouillon de la description. Il dit avoir dirigé ce travail et réalisé les mesures sur sa propre machine. La note ne permet pas de mesurer séparément la part de l’assistant dans chacune des décisions techniques.
Le même document montre les limites du résultat actuel : Torvalds liste les essais qui manquent et les problèmes qu’il n’a pas encore résolus. L’information vérifiable est donc l’existence d’une série expérimentale élaborée avec un assistant de code et accompagnée de mesures locales. Le travail de revue du noyau et la décision éventuelle de fusion restent à venir.
Les prestations d’automatisation IA de DjeremIA sont décrites dans la rubrique Services.