Une équipe de Google Research a mis en ligne Harness², un cadre logiciel open source sous licence Apache 2.0 qui cherche à améliorer un agent IA sans réentraîner le modèle qui le fait tourner. Le code est publié sur GitHub et s’accompagne d’une prépublication déposée sur arXiv le 9 octobre 2026. Plusieurs médias ont présenté le projet comme des « agents qui s’améliorent seuls ». La documentation décrit quelque chose de plus circonscrit : une méthode d’édition automatique de l’environnement de travail de l’agent, évaluée sur trois bancs d’essai professionnels.
Ce que les auteurs appellent un « harness »
Le dépôt définit le harness comme le système placé autour d’un modèle pour qu’il agisse en agent : les consignes, les outils, la mémoire, les compétences, l’orchestration. Harness² expose huit composants modifiables : le prompt système, les garde-fous, la mémoire, les instructions d’usage des outils, les sous-agents, les compétences, les scripts et les plugins. Les poids du modèle restent figés pendant tout le processus.
Ce point de départ rejoint un constat que les éditeurs d’outils pour développeurs répètent depuis plusieurs mois : à modèle identique, deux environnements d’exécution donnent des résultats très différents. Le résumé de l’article le formule ainsi : les capacités d’un agent dépendent de son modèle mais aussi de son harness d’exécution. Harness² propose d’optimiser ce second étage de façon automatique plutôt qu’à la main.
Deux niveaux de récursion
Le premier niveau travaille sur la tâche en cours. Le cadre propose des modifications du harness, les essaie sur la même tâche, puis compose une version affinée à partir des différences de comportement observées entre les exécutions. Les auteurs nomment cette étape Propose-Probe-Compose. Son intérêt annoncé est de fonctionner sans vérificateur de vérité terrain : dans une tâche ouverte et inédite, il n’existe pas de bonne réponse connue à l’avance pour noter chaque essai.
Le second niveau conserve une trace d’une tâche à l’autre. Après chaque tâche, un « harness d’amélioration » persistant enregistre la configuration adoptée et les enseignements que les auteurs jugent étayés par les exécutions. Ce harness sert ensuite à guider les modifications sur les tâches suivantes. L’article présente ce mécanisme comme la réponse à une limite connue de l’auto-amélioration récursive, qui reste souvent spécifique à une tâche et se généralise mal.
La récursion au niveau de la tâche peut être élargie de deux manières. En mode parallèle, le cadre teste plusieurs harness candidats, généraux et spécifiques au domaine, puis compose des versions à partir des mêmes observations. En mode séquentiel, il enchaîne plusieurs étapes successives en transportant le harness affiné et les preuves accumulées.
Les résultats publiés
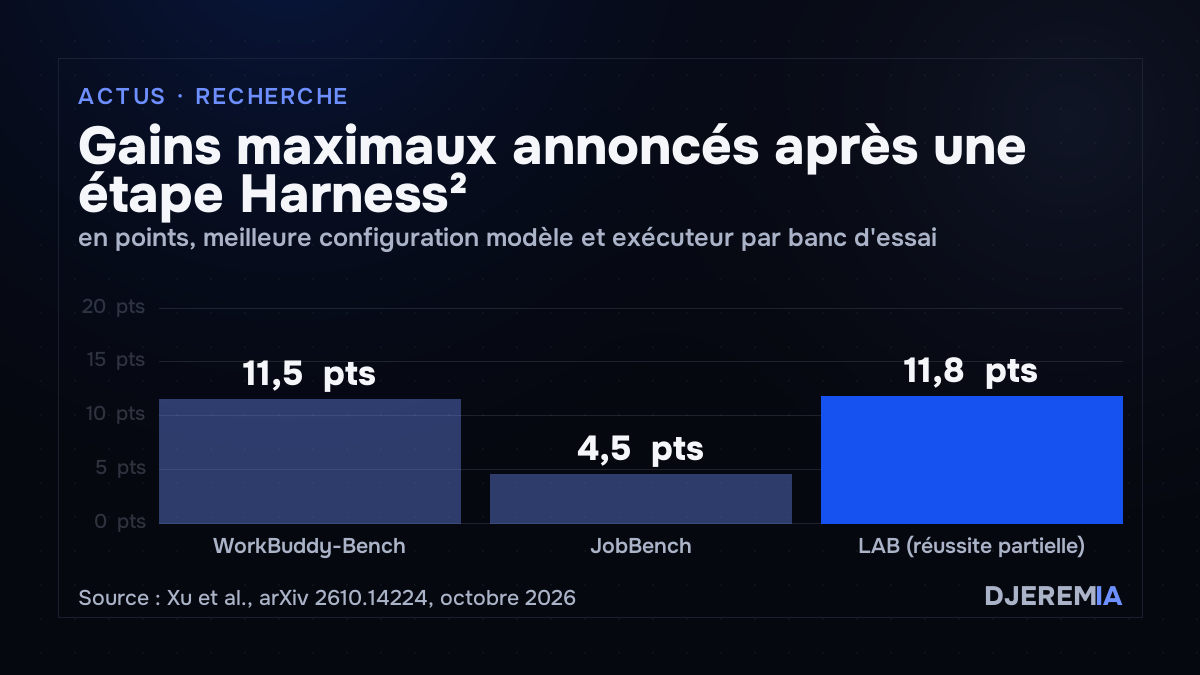
Les auteurs ont testé Harness² sur trois bancs d’essai : JobBench (travail professionnel), LAB (travail juridique) et WorkBuddy-Bench (bureautique, web et code), avec quatre configurations combinant les modèles GLM-5 et Gemini 3.5 Flash et des exécuteurs OpenCode ou Codex. Une seule étape d’amélioration produit, selon eux, des gains allant jusqu’à 11,5 points sur WorkBuddy-Bench, 4,5 points sur JobBench et 11,8 points de pourcentage sur le taux de réussite partielle de LAB. Augmenter le nombre d’itérations apporterait des gains supplémentaires.
Ces chiffres sont des maxima mesurés par l’équipe sur ses propres configurations. La prépublication n’a pas encore fait l’objet d’une relecture par des pairs, et les écarts varient selon le banc d’essai et le couple modèle-exécuteur. Le dépôt fournit les scripts de reproduction, ce qui permettra à des équipes extérieures de vérifier si les gains tiennent sur d’autres modèles et d’autres tâches.
Les conditions d’usage et les réserves de la documentation
Le projet porte la mention habituelle des dépôts de Google Research : il ne s’agit pas d’un produit officiellement pris en charge par Google. L’installation demande Linux, Python 3.12 et le gestionnaire uv. Une démonstration locale tourne sans clé d’accès à un modèle ; les bancs d’essai complets passent par Vertex AI, Node.js et, pour WorkBuddy-Bench, Docker. La documentation prévient que les exécutions appuyées sur un modèle entraînent des coûts d’API et conseille de commencer par une petite sélection de tâches.
Elle signale aussi un point de sécurité. L’accès réseau des exécuteurs n’est pas restreint par défaut et Codex y tourne avec son bac à sable désactivé. Les auteurs recommandent de configurer des restrictions réseau avant toute évaluation, notamment parce que les grilles de notation publiques de certains bancs d’essai sont accessibles en ligne et pourraient fausser les résultats.
L’article est signé par neuf chercheurs, dont Ruiyao Xu, Yanfei Chen, Chen-Yu Lee et Tomas Pfister. Leur contribution se situe dans un champ actif, celui de l’optimisation automatique des agents à modèle constant. La portée réelle de Harness² dépendra de sa reprise par d’autres équipes et de résultats obtenus hors des trois bancs d’essai choisis par ses auteurs.
Les prestations d’automatisation IA de DjeremIA sont décrites dans la rubrique Services.
Sources primaires : dépôt google-research/harness2 sur GitHub ; prépublication arXiv 2610.14224, 9 octobre 2026.