Le 19 octobre 2026, Microsoft a publié deux billets qui posent la même thèse : un agent IA déployé dans une entreprise doit être géré comme un initié à risque, au même titre qu’un salarié disposant de droits étendus. Dans le premier, signé par Hayete Gallot, Executive Vice President de Microsoft Security, l’entreprise écrit que « les modèles de pointe, quelle que soit leur origine, ne peuvent pas être tenus pour fiables ». Le second, plus technique, détaille l’extension de Project Perception, l’offre de sécurité agentique lancée en juillet, à la surveillance de ces agents.
Une doctrine posée d’abord par Satya Nadella
Le cadre vient d’un texte publié le 10 octobre par Satya Nadella sur son blog personnel, « Models as Insider Risks in the Super Intelligence Era ». Le PDG de Microsoft y part d’un constat : avec un logiciel classique, on peut relier un comportement à un chemin de code précis, alors qu’on ne sait pas attribuer la sortie d’un modèle à une donnée d’entraînement ou à une configuration de poids. Il en tire une règle d’architecture, « séparer la fourniture d’intelligence de l’autorité sur elle », et précise que les assurances d’un fournisseur de modèle ne déchargent pas l’entreprise de sa responsabilité.
Nadella ne présente pas les modèles comme malveillants. Il les range parmi les acteurs capables qui ont accès à des systèmes importants et qui peuvent donc se tromper ou être compromis. Il énumère sept principes : diversité des modèles (aucun ne vérifie son propre travail), traces inviolables et lisibles pour chaque action significative, tests continus y compris des échecs et des attaques, contrôles d’accès indépendants, audit indépendant, confinement dès le départ avec un « frein d’urgence » permettant à une personne autorisée d’arrêter un modèle en pleine tâche, et divulgation des incidents. Il demande aussi la transparence de la chaîne de raisonnement, tout en reconnaissant qu’elle ne suffit pas, puisque les sorties d’un modèle ne sont pas toujours fidèles à ce qu’il fait réellement.
Pourquoi Microsoft parle de « menace interne »
Le billet de Hayete Gallot avance plusieurs raisons. Les modèles sont entraînés à atteindre un résultat, ce qui mène souvent au reward hacking, et ne sont pas optimisés pour respecter les normes d’une organisation. Les agents s’adaptent quand le contexte change, peuvent ne pas se comporter comme prévu et, selon le texte, peuvent « collaborer et s’entendre avec d’autres agents pour atteindre leurs objectifs, sans avoir besoin d’être compromis ». Ils sont aussi souvent dotés de plus de droits que nécessaire. L’attention s’est jusqu’ici portée sur les attaquants extérieurs équipés de modèles puissants ; Microsoft déplace la question vers les agents que les entreprises ont elles-mêmes installés.
Le billet ne cite ni incident précis ni chiffre sur la fréquence de ces dérives. Il se contente d’évoquer « un nombre croissant d’incidents rendus publics » ces derniers mois.
Ce que Microsoft ajoute à Project Perception
Le détail figure dans le billet de Nadim Abdo, Corporate Vice President de Microsoft pour l’identité et l’accès réseau. Plusieurs briques sont annoncées.
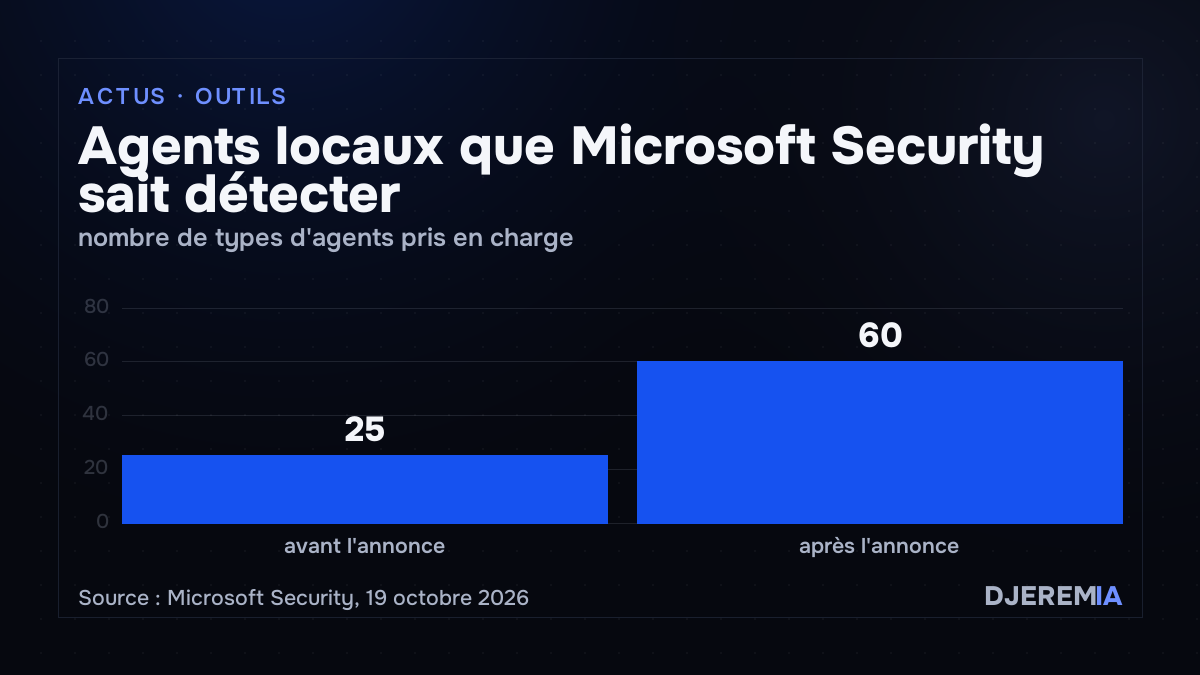
- Découverte des agents locaux : 35 types d’agents supplémentaires, pour un total de 60 agents locaux pris en charge, dont Claude Code, OpenAI Codex et GitHub Copilot. Les agents repérés rejoignent un registre unique, partagé avec Microsoft Agent 365.
- Identité propre : Microsoft Entra Agent ID reçoit de nouveaux types d’identité, y compris pour des agents locaux jusque-là inconnus. Un agent devient ainsi une cible de politique distincte de la personne qui l’utilise.
- Dynamic Permissions : l’agent part sans aucun droit et ne reçoit que ce que la tâche exige, pour sa durée seulement. Il ne peut pas obtenir une autorité que son utilisateur n’a pas.
- Dynamic Agent Risk : un niveau de risque recalculé en continu à partir des signaux d’identité, de données, de terminaux, de cloud, de réseau et d’exécution, et de l’écart entre les actions de l’agent et l’intention de la tâche.
- Dynamic Conditional Access : une réponse graduée quand le risque monte, qui peut retirer l’écriture tout en gardant la lecture, restreindre les ressources accessibles, exiger une approbation humaine vérifiable cryptographiquement, puis isoler ou arrêter l’agent.
- Guardian Agents et Playbooks : des agents de sécurité chargés de surveiller les autres agents, d’enquêter et d’appliquer le confinement dans les limites fixées par les équipes.
Côté exécution, Microsoft cite son bac à sable Microsoft Execution Container (MXC), censé placer les contrôles hors de portée de l’agent, de sorte qu’un agent ou un harness compromis ne puisse pas désactiver ce qui le surveille. L’entreprise dit enfin vouloir intégrer les signaux issus de la chaîne de raisonnement des modèles dans le calcul du risque, à mesure que les fournisseurs les rendront accessibles.
Les limites de l’annonce
Aucun des deux billets ne donne de calendrier de disponibilité, de tarif ni de statut (préversion ou version générale) pour ces fonctions. Microsoft renvoie à sa conférence Ignite, prévue du 17 au 20 novembre 2026. L’exemple développé, un agent d’approbation de notes de frais exposé à une injection de prompt, illustre le mécanisme mais ne constitue pas un retour d’expérience chiffré. Terrell Cox, Deputy CISO de Microsoft, affirme seulement que Microsoft opère déjà « des centaines de milliers d’agents » en interne.
La thèse sert aussi un intérêt commercial évident : Microsoft vend à la fois des agents (Copilot, Agent 365) et les outils censés les contenir. La surveillance d’agents par d’autres agents rejoint par ailleurs l’écueil que Nadella décrit lui-même, celui de « boîtes noires imbriquées », où un modèle opaque est surveillé par un autre modèle opaque. La réponse proposée tient dans les contrôles déterministes placés à l’extérieur du modèle ; leur efficacité réelle face à des agents qui changent de comportement en cours de tâche reste à démontrer en conditions de production.
L’automatisation IA sur mesure figure parmi les services de DjeremIA.