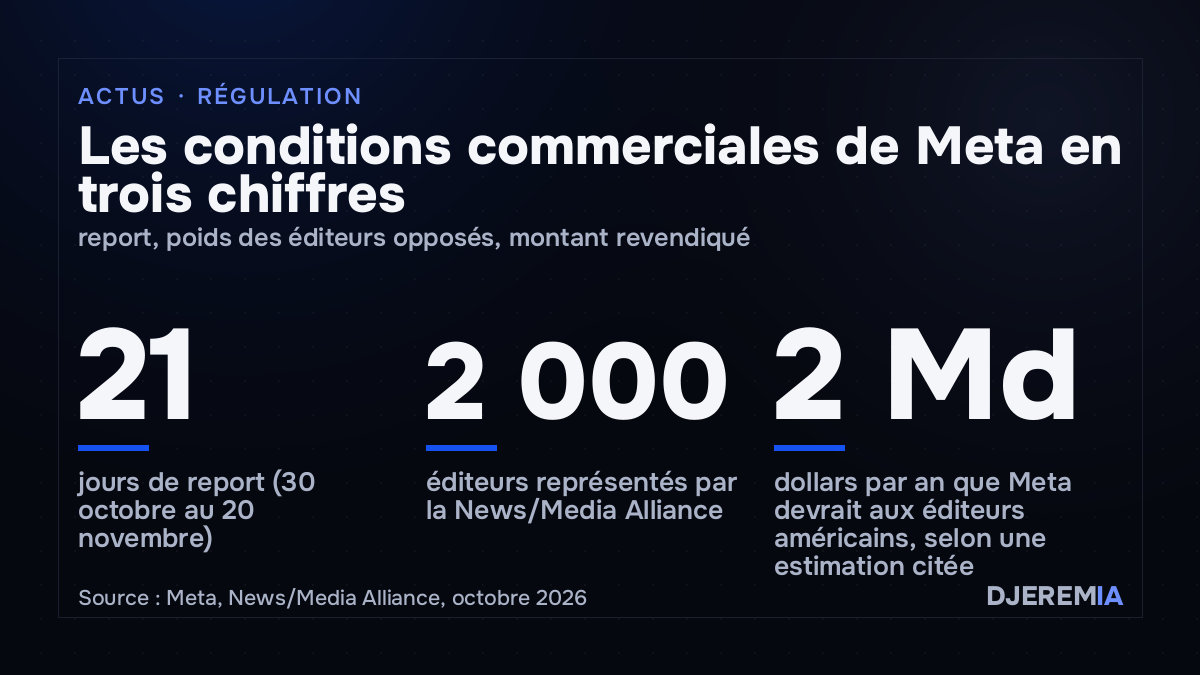
Meta a repoussé au 20 novembre 2026 l’entrée en vigueur de ses nouvelles conditions commerciales, initialement prévue le 30 octobre. Le report, de trois semaines, est intervenu sans annonce publique, un jour après une lettre de la News/Media Alliance, principale organisation professionnelle de la presse américaine, qui demandait à Mark Zuckerberg de retirer le texte. Le cœur du litige ne bouge pas : une clause qui autorise Meta à explorer de façon automatisée les sites « associés » aux comptes professionnels de Facebook, Instagram, Messenger et WhatsApp.
Ce que dit la clause contestée
Le texte publié par Meta sur sa page de prévisualisation, désormais daté du 20 novembre, prévoit que l’entreprise, ou toute entité agissant pour son compte, peut utiliser des « web scrapers, bots, robots, spiders, crawlers » et créer des « identifiants de test » pour accéder, indexer, mettre en cache, analyser et collecter les domaines, pages et URL associés aux produits ou services d’un compte professionnel, puis en récupérer périodiquement les mises à jour.
Le périmètre est large. Les comptes professionnels servent à gérer des pages, des groupes, des publicités et des messages marketing depuis Meta Business Suite. Comme l’a relevé Nieman Lab, qui a révélé l’affaire le 15 octobre à partir du signalement d’un éditeur indépendant, la quasi-totalité des rédactions en possèdent au moins un. Aucune option de refus n’est prévue : la notice de mise à jour indique qu’un utilisateur en désaccord doit cesser d’utiliser les produits Meta à des fins commerciales.
Le mot « train » retiré, la portée jugée intacte
La première version autorisait Meta à utiliser « tout contenu » de ces sites pour « fournir, développer, améliorer, rechercher, entraîner et maintenir » ses produits. Or les propres conditions de Meta rangent « AI at Meta » parmi ces produits. Face aux critiques, l’entreprise a retouché le texte le week-end des 17 et 18 octobre, sans en avertir les utilisateurs selon Ars Technica. La version actuelle supprime « entraîner » et « tout contenu » : la collecte sert désormais à « fournir, développer, améliorer, rechercher et maintenir des produits publicitaires et professionnels », ainsi qu’à préserver l’intégrité et la sécurité des services.
Les juristes consultés par Nieman Lab estiment que la modification ne règle rien. Pour Matt Topic, avocat spécialisé en propriété intellectuelle, « développer » un « produit professionnel », expression non définie, suffit à couvrir l’entraînement d’outils d’IA destinés aux entreprises. James Grimmelmann, professeur de droit à Cornell, juge la formulation « assez large pour y faire passer un camion » et note que la notion de site « associé » permet toujours de parcourir des sites entiers. La mention des identifiants de test pose une autre question, restée sans réponse de Meta : elle permettrait techniquement de s’inscrire comme un faux utilisateur et de franchir un mur d’inscription.
La position de Meta : robots.txt reste valable
Meta soutient que la clause ne fait que regrouper des dispositions jusqu’ici dispersées, notamment dans ses conditions sur l’IA générative publicitaire, et qu’elle ne modifie pas l’usage de ses robots d’exploration. « Ce n’est pas une affaire de scraping des sites d’information », a déclaré un porte-parole à Ars Technica, en ajoutant que les propriétaires de contenu peuvent toujours exprimer leurs préférences par le fichier robots.txt. Pour justifier le report, un porte-parole a expliqué à Fast Company et à The Verge que le délai doit permettre d’expliquer « ce qui change et ce qui ne change pas », y compris le fonctionnement des robots de Meta.
C’est précisément ce point que contestent les spécialistes. Le respect de robots.txt est volontaire, alors que des conditions d’utilisation acceptées ont une valeur contractuelle. Benjamin Sobel, professeur de droit à l’université du Wisconsin, estime qu’une préférence non opposable juridiquement « peut tout aussi bien être ignorée ». Il suggère que Meta s’engage noir sur blanc, dans le texte, à respecter ces instructions. La version du 20 novembre ne contient pas cet engagement.
Une contestation des deux côtés de l’Atlantique
La lettre de la News/Media Alliance, envoyée le 22 octobre au nom de plus de 2 000 éditeurs, situe le problème sur le terrain de la concurrence : Meta utiliserait sa position dans les réseaux sociaux pour obtenir gratuitement un contenu qui se négocie ailleurs sous licence. Elle souligne aussi que les éditeurs ne peuvent pas bloquer les robots de Meta sans nuire à leur propre diffusion sur ses plateformes, et cite une estimation selon laquelle Meta devrait déjà près de 2 milliards de dollars par an aux éditeurs américains. Danielle Coffey, sa présidente, avait qualifié dès le 16 octobre ces conditions de « scandaleuses et probablement illégales ».
En Europe, l’European Publishers Council a demandé l’intervention de la Commission européenne. Au Royaume-Uni, la News Media Association parle d’un « accaparement éhonté » et appelle les régulateurs à agir. Selon Reuters, des éditeurs et des annonceurs ont demandé le 22 octobre aux autorités de concurrence européenne et britannique d’obtenir la suspension du texte. Benjamin Sobel rapproche le mécanisme de la notion de « vente liée » en droit de la concurrence : l’accès aux outils professionnels de Meta est conditionné à l’acceptation de l’exploration.
Ce que le report change, et ce qu’il ne change pas
Le report ne modifie pas la clause : la page de prévisualisation affiche le même texte que la version retouchée, avec une nouvelle date d’effet. Il laisse trois semaines supplémentaires aux régulateurs saisis et aux discussions avec les éditeurs. L’affaire s’inscrit dans un contexte où plusieurs procès entre éditeurs et développeurs d’IA, dont une action collective de cinq grands éditeurs de livres contre Meta déposée en mai, sont encore pendants, et où la question de l’entraînement des modèles sur des contenus protégés n’est pas tranchée par les tribunaux américains. Aucune réponse de la Commission européenne ni de l’autorité britannique de la concurrence n’a été rendue publique à ce stade.
Les formations sur l’IA de DjeremIA sont présentées dans une rubrique distincte.