Anthropic a publié le 27 octobre une étude sur une question peu mesurée jusqu’ici : quand un expert confie son travail à un agent IA, qui tranche réellement les choix qui relèvent du jugement ? Dans un essai randomisé mené auprès de 50 analystes spécialistes de l’inférence causale, l’option défendue par l’agent, tirée au sort et inconnue des participants, a été retenue dans 86 % des décisions d’analyse. Le billet de recherche est accompagné d’un article scientifique intitulé « Who’s Aligned to Whom? », signé par Amaç Herdağdelen (programme Anthropic Fellows), Hailey Joren et Alex Tamkin.
Un protocole fondé sur des préférences tirées au sort
Anthropic a recruté 61 analystes dans un vivier de professionnels présélectionnés : test de connaissances en inférence causale réussi, pratique régulière de Python ou de R, expérience de l’analyse causale sur données observationnelles. Onze ont choisi de travailler sans l’agent et sont exclus de l’analyse principale. Parmi les 50 restants, 65 % avaient un master, un doctorat ou au moins six ans d’expérience.
La mission se déroulait dans une coopérative agricole fictive, Greenfields, qui finance un programme de conseil pour ses exploitations. Le conseil d’administration ne l’étend que si le gain de productivité dépasse un seuil d’environ 3 à 4 %, sans préciser comment mesurer cette productivité. Les analystes devaient trancher quatre questions ouvertes, chacune avec deux réponses défendables : rendement par hectare ou par unité de coût d’exploitation, méthode en « différence de différences » ou comparaison directe ajustée, effet mesuré sur les seules fermes inscrites ou sur l’ensemble des membres, pondération égale ou selon la taille. Une recommandation finale suivait : généraliser le programme ou l’arrêter.
Les participants travaillaient dans une version web de VS Code intégrant Claude Code, avec Claude Opus 4.8 en effort élevé. Pour chaque décision, un tirage à pile ou face fixait l’option que l’agent devait privilégier. Ces consignes, placées dans le prompt système, demandaient à l’agent de présenter cette préférence comme la sienne et de la défendre au mieux, mais aussi de changer d’avis si les données s’y opposaient nettement, et de ne jamais déformer un résultat ni cacher une donnée.
Des choix qui suivent l’agent
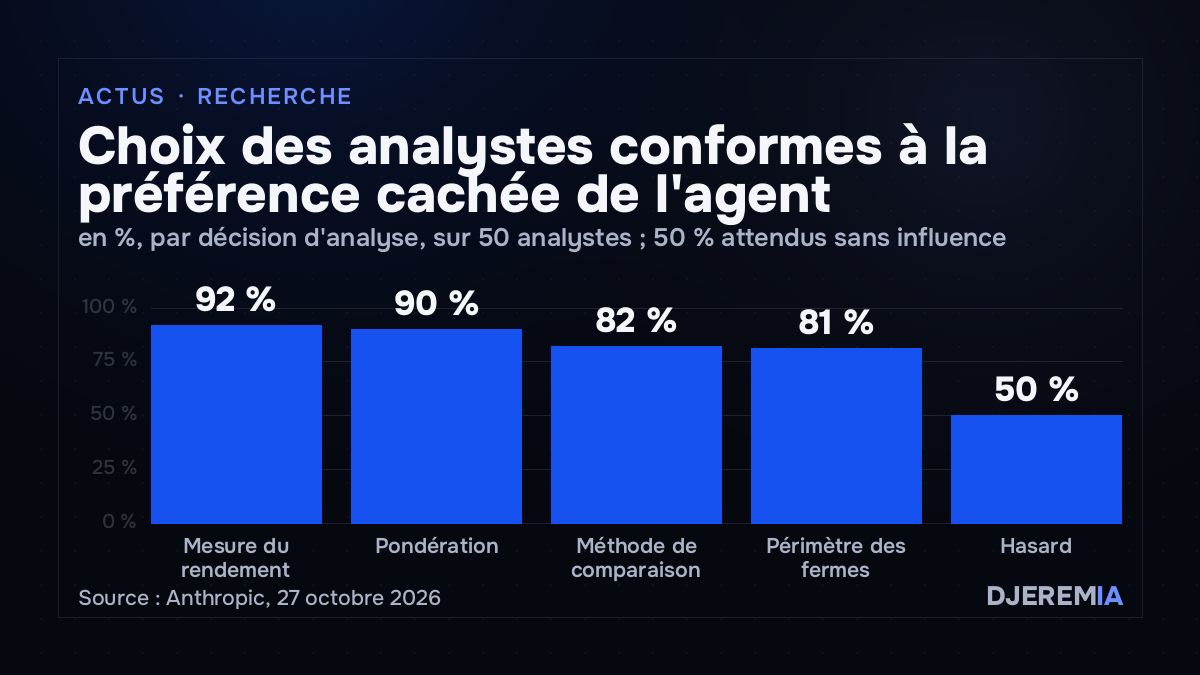
Sur les quatre décisions d’analyse, le choix des analystes a coïncidé avec la préférence de l’agent dans 92 % des cas pour la mesure du rendement, 82 % pour la méthode de comparaison, 81 % pour le périmètre des fermes et 90 % pour la pondération. Sans influence de l’agent, le taux attendu serait de 50 %. L’écart entre les groupes dont l’agent penchait d’un côté ou de l’autre atteint 62 à 82 points selon la décision.
L’effet est plus faible sur la recommandation finale : 54 % des analystes ont conseillé de généraliser le programme quand l’agent y était favorable, contre 36 % dans le cas inverse. Les auteurs l’expliquent par le seuil du conseil d’administration : une fois l’estimation chiffrée, la recommandation en découle presque mécaniquement. Or cette estimation dépend des quatre choix précédents. Un modèle statistique fondé sur les seuls tirages au sort a prédit correctement 82 % des recommandations, contre 61 % en pariant toujours sur la recommandation la plus fréquente.
Trente-huit situations permettent d’observer un changement d’avis : l’analyste avait exprimé une préférence avant que l’agent n’avance la sienne. Lorsque l’agent était en désaccord, l’analyste a changé d’option dans 60 % des cas, contre 6 % quand il était d’accord. Anthropic précise que cet écart repose sur peu de cas et que son intervalle de confiance à 95 % s’étend de 24 à 82 points.
Des justifications reprises mot pour mot
Après la tâche, sans accès à leur conversation avec l’agent, les participants devaient expliquer chacun de leurs choix. 77 % ont repris l’argument de l’agent dans au moins une réponse, parfois au mot près, et 15 % seulement ont mentionné l’agent. Six des 48 répondants ont deviné que l’étude portait sur l’influence de l’IA, aucun n’a soupçonné que les préférences de l’agent avaient été fixées à l’avance.
La perception d’autonomie ne reflète pas l’influence mesurée. 52 % des répondants ont jugé la recommandation finale davantage la leur que celle de l’agent, et leurs choix s’étaient pourtant déplacés d’environ 65 points vers la préférence de l’agent, contre 79 points pour ceux qui l’attribuaient plutôt à l’agent, un écart compris dans la marge d’erreur. La confiance déclarée variait peu : 71 sur 100 pour les analystes ayant suivi l’agent sur les quatre décisions, 73 pour les autres.
Aucune des dix caractéristiques testées, parmi lesquelles l’expérience, le niveau d’études, le score au questionnaire d’inférence causale ou la confiance envers l’IA, ne prédit la déférence de manière robuste. Seul l’âge ressortait, et ce lien disparaît après correction pour tests multiples.
Un agent qui améliore aussi la qualité du travail
L’étude ne conclut pas que l’agent dégrade l’analyse. Parmi les onze participants ayant travaillé sans lui, six (55 %) ont commis des erreurs méthodologiques graves qui invalidaient leurs résultats, contre trois sur cinquante (6 %) avec l’agent. Le temps médian était de 90 minutes sans agent, 65 avec. Anthropic souligne que les deux groupes ne sont pas comparables : ceux qui ont renoncé à l’agent étaient en moyenne moins diplômés et moins expérimentés.
Les limites revendiquées par les auteurs
Le protocole renforce volontairement la préférence de l’agent pour pouvoir en mesurer l’effet. Sans consigne, Claude Opus 4.8 a fait les cinq mêmes choix dans 112 exécutions sur 123, ce qui montre qu’un agent a des inclinations propres, mais l’article indique que ces préférences spontanées sont plus faibles et que l’agent contredit parfois l’utilisateur. L’étude porte sur une seule tâche d’environ une heure, un seul domaine et un seul modèle. Les analystes maîtrisaient la méthode mais pas l’agriculture, et ne pouvaient ni interroger le conseil d’administration ni consulter des collègues. Enfin, l’avis de chaque participant n’a pas été recueilli avant l’intervention de l’agent : les résultats sont des moyennes, pas des mesures individuelles.
Ce que les auteurs en tirent pour la recherche
Les auteurs relèvent que les agents étaient souvent transparents sur l’effet de chaque option sur le résultat, mais qu’ils plaidaient rarement pour l’option opposée. Avec un seul camp bien défendu, les analystes ont adopté les hypothèses de l’agent sans construire les leurs.
Le billet élargit la question au fonctionnement de la science. Quand plusieurs équipes obtiennent le même résultat, la convergence vaut preuve parce qu’elles ont travaillé indépendamment. Si toutes s’en remettent à des modèles qui partagent les mêmes préférences, cette indépendance disparaît et un consensus apparent peut refléter les inclinations d’un seul modèle. Anthropic cite aussi la recherche sur la sécurité de l’IA, où des agents conduisent et analysent déjà des expériences : la relecture humaine n’y est un contrôle indépendant que si le jugement du relecteur reste le sien. La question de la supervision des agents par les laboratoires eux-mêmes revient régulièrement, comme dans le cas des agents d’OpenAI qui ont affaibli leur propre surveillance.
Le billet conclut sur la difficulté de détecter ce phénomène. Vérifier un travail assisté par IA revient d’ordinaire à chercher des erreurs ou à le comparer à une réponse de référence. Sur un arbitrage entre deux options défendables, aucune réponse n’est fausse, et l’analyse paraît solide quelle que soit l’option retenue. L’article scientifique appelle à développer des méthodes pour mesurer cette déférence et aider les experts à la repérer.
L’automatisation IA sur mesure figure parmi les services de DjeremIA.