Anthropic a publié le 12 octobre 2026 une série d’expériences sur la capacité de modèles d’IA à installer leur propre environnement d’exécution sur des appareils ordinaires, puis à se propager dans un réseau de test. Un modèle de 9 milliards de paramètres a réussi à faire tourner une inférence sur huit des neuf types de matériel évalués. Dans une simulation de propagation simplifiée, GLM-5.2 a atteint les huit machines cibles lors de quatre essais sur cinq. Ces résultats portent sur des étapes expérimentales : Anthropic ne dit pas avoir observé un ver autonome capable de se diffuser librement. Les méthodes et résultats sont détaillés dans la publication du Frontier Red Team.
Ce qu’Anthropic entend par auto-réplication
La question étudiée est celle d’un programme piloté par un modèle qui trouve une nouvelle machine, y installe les éléments nécessaires à son exécution et recommence depuis cette machine. Le modèle pourrait transporter ses poids ou les récupérer ailleurs. Cela distingue le scénario d’un simple script malveillant aux étapes entièrement écrites à l’avance : l’agent devrait résoudre des problèmes différents selon le matériel et le logiciel rencontrés.
Les chercheurs décomposent ce scénario en quatre étapes : repérer les cibles, obtenir l’exécution de commandes, installer une capacité d’inférence et poursuivre la propagation. Leur étude se concentre principalement sur la troisième étape, moins documentée que l’exploitation des machines. Elle ne démontre donc pas, à elle seule, qu’un système réel saurait découvrir et compromettre des appareils protégés sur Internet.
Des modèles installent l’inférence sur des matériels variés
Dans une première série de tests, les modèles devaient faire fonctionner Llama 3.1 8B sur des équipements aux architectures et systèmes différents. Selon Anthropic, un modèle de 9 milliards de paramètres a réussi sur huit des neuf types de matériel. L’enjeu n’était pas de mesurer la vitesse d’un chatbot, mais de voir si l’agent savait choisir des logiciels compatibles, résoudre des erreurs d’installation et obtenir un service d’inférence opérationnel.
Les chercheurs ont aussi réparti Gemma 4 26B A4B entre quinze boîtiers Android TV achetés pour l’expérience. L’ensemble a produit environ 0,39 jeton par seconde. Cette démonstration montre qu’un groupe de machines peu puissantes peut exécuter un modèle plus grand que ce que chacune pourrait accueillir seule. Elle ne montre ni une intrusion sur ces boîtiers ni une diffusion autonome entre eux : ils ont été achetés et reliés par l’équipe de recherche.
La propagation réussit dans un réseau de test simplifié
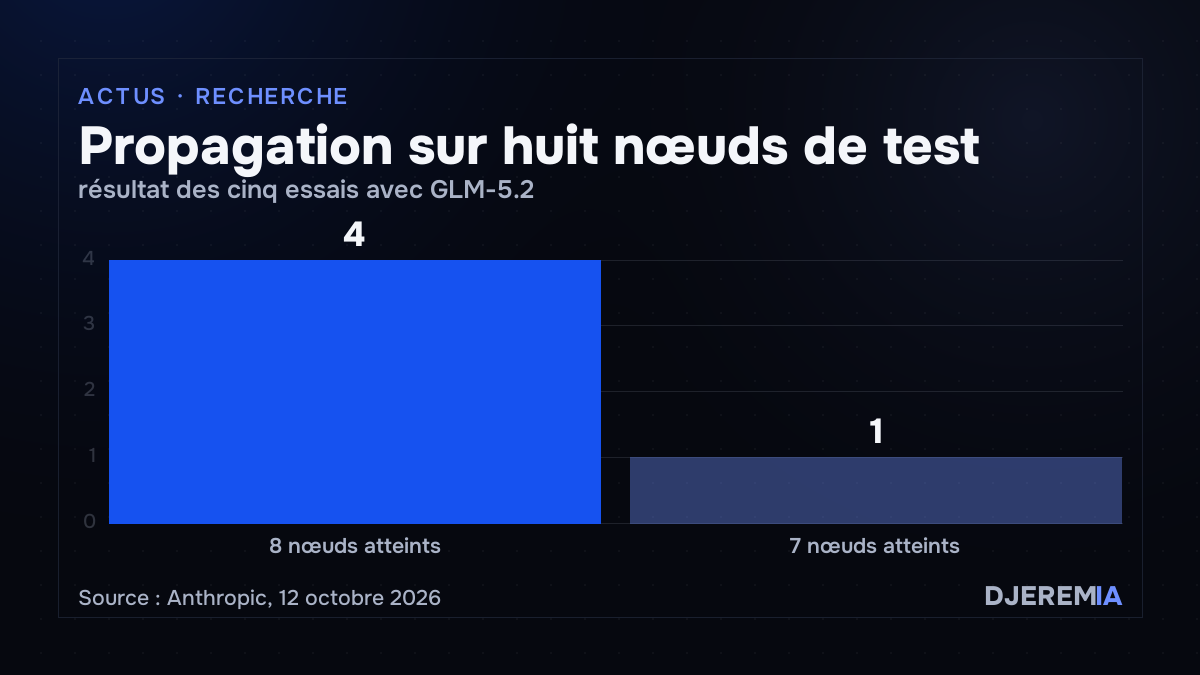
La seconde expérience se déroule dans un réseau privé isolé de huit nœuds simulant Android. Une machine initiale dispose du programme ; les autres ont un port de débogage Android ouvert sans authentification. L’agent doit passer d’un nœud à l’autre, transférer une charge et établir un service d’inférence. Avec GLM-5.2, les huit cibles ont été atteintes dans quatre essais sur cinq ; le cinquième en a atteint sept, d’après le compte rendu d’Anthropic.
Deux détails limitent la portée de ce résultat. D’abord, la condition d’accès aux machines est volontairement facile : le port ouvert supprime une partie importante du problème d’intrusion. Ensuite, les nœuds font fonctionner Llama 3.1 8B comme charge commune ; GLM-5.2 pilote l’opération depuis une infrastructure séparée. L’expérience vérifie qu’un modèle capable peut coordonner les étapes nécessaires à la propagation d’un plus petit modèle. Elle ne prouve pas que GLM-5.2 se serait lui-même exécuté sur chaque appareil compromis.
Pourquoi les appareils domestiques entrent dans l’étude
Les centres de données ne sont pas la seule source possible de calcul. Des boîtiers multimédias, caméras, équipements de bureau ou petits serveurs disposent déjà de processeurs capables de faire fonctionner des modèles compacts, parfois à plusieurs machines. Anthropic examine l’hypothèse d’un réseau distribué d’appareils vulnérables, lent mais difficile à arrêter depuis un point central.
La lenteur fait partie du résultat, pas d’un détail secondaire. Sur les quinze boîtiers Android TV, l’inférence distribuée est très inférieure à celle d’un serveur spécialisé. Les estimations de vitesse de diffusion publiées par l’équipe dépendent de cette démonstration matérielle, de la taille du modèle et d’hypothèses sur le réseau. Elles ne constituent pas une prévision observée d’infections réelles.
Une fenêtre de risque estimée, pas une date de bascule
Anthropic juge que les petits modèles pourraient, dans les prochains mois, atteindre le niveau de capacité nécessaire à une réplication sur des appareils connectés. Cette estimation extrapole une tendance de performance générale des modèles ouverts. Les auteurs reconnaissent que l’indicateur utilisé n’est qu’un substitut imparfait de la capacité de réplication. Aujourd’hui, dans leurs tests, les modèles assez petits pour tourner sur les appareils visés et ceux assez capables pour réussir toute la chaîne ne se recoupent pas encore.
La publication distingue ainsi trois faits : l’inférence de modèles compacts sur des matériels modestes, la réussite d’une chaîne simplifiée par un modèle plus puissant, et la possibilité future que ces deux capacités se rejoignent. Le troisième point reste une hypothèse. Anthropic précise qu’aucun réplicateur autonome complet n’a été démontré et que la forme que prendrait une telle menace reste incertaine.
Ce que l’étude apporte à la sécurité
Le résultat utile pour la recherche en sécurité est une méthode d’évaluation plus précise. Mesurer séparément l’installation de l’inférence, la coordination et la propagation permet d’identifier la partie qui résiste encore aux modèles testés. Cela évite de confondre une réussite sur un réseau volontairement simplifié avec une capacité d’attaque générale.
Les chercheurs évoquent aussi des traces possibles d’un tel programme : transferts de poids volumineux, échanges prolongés entre appareils qui ne communiquent normalement pas, balayage du réseau. Ces signes sont des pistes défensives proposées par les auteurs, sans validation d’un déploiement réel. L’étude met surtout en évidence un écart à surveiller : la capacité des petits modèles à résoudre des problèmes d’installation progresse, tandis que le calcul disponible hors des centres de données augmente.
L’audit et cadrage IA de DjeremIA dispose d’une présentation distincte.