Anthropic a lancé le 9 novembre 2026 Claude Fable 5.2 et Claude Mythos 5.2. Les deux noms désignent le même modèle sous-jacent, mais Fable applique des garde-fous renforcés en cybersécurité et en biologie. Fable est disponible sur les plateformes publiques ; Mythos reste réservé à des organisations vérifiées pour ces usages sensibles.
Le communiqué d’Anthropic du 9 novembre présente des progrès sur le code, la recherche et l’ingénierie. Les chiffres proviennent surtout de tests publiés par l’entreprise. Ils décrivent des tâches précises, pas une mesure universelle de la qualité du modèle.
Un même moteur, deux politiques d’accès
La distinction entre Fable et Mythos concerne principalement les usages autorisés. Fable 5.2 bloque la plupart des demandes avancées de cybersécurité et de recherche biologique. Anthropic indique que certaines requêtes refusées par Fable sont prises en charge par un autre modèle avec un message explicite. Mythos 5.2 est accessible sur candidature au sein des programmes de vérification cyber et sciences de la vie.
- Fable 5.2 : accès public dans Claude et via l’API, avec restrictions sur certains domaines à risque.
- Mythos 5.2 : même base technique, avec accès encadré pour les équipes autorisées.
- Mode rapide : option annoncée sur Claude Code et certaines plateformes API, avec un tarif distinct.
Anthropic recommande elle-même de commencer par Opus 5.5 pour la majorité des tâches de code et de travail intellectuel. Fable et Mythos visent les problèmes techniques plus difficiles ou ouverts. Cette recommandation nuance l’idée qu’un nouveau modèle devrait remplacer le précédent dans tous les workflows.
Ce que montrent les tests de code publiés
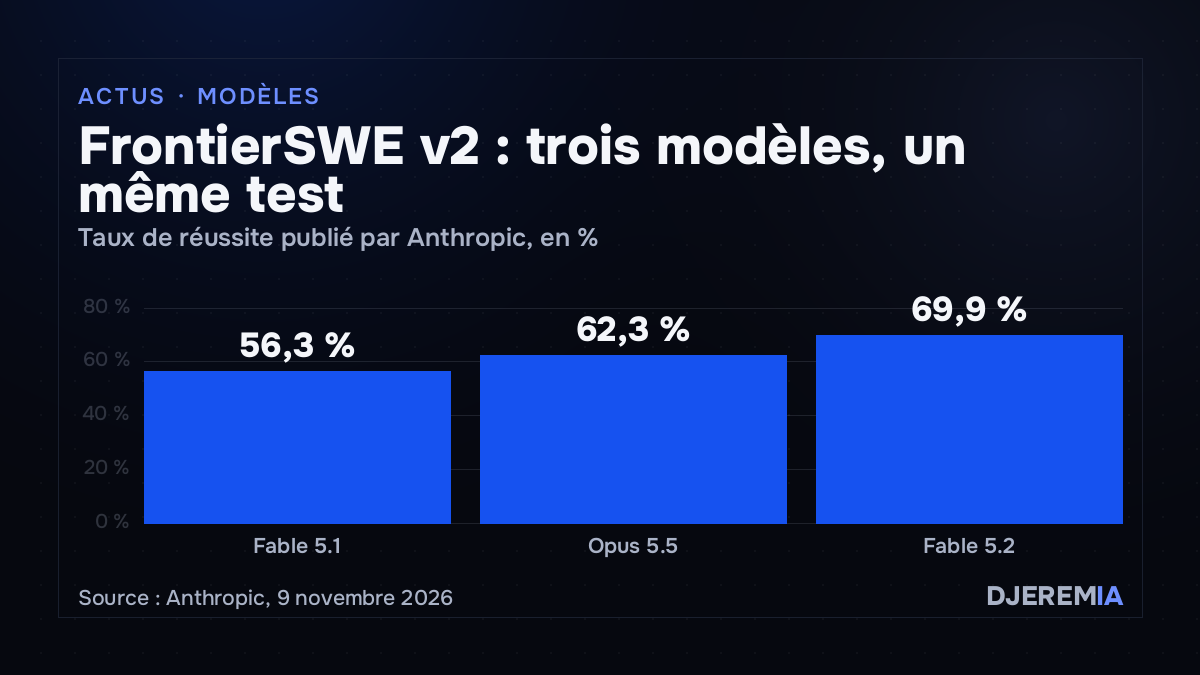
Sur FrontierSWE v2, un test de résolution de tâches logicielles agentiques, Fable 5.2 atteint 69,9 %, contre 56,3 % pour Fable 5.1 et 62,3 % pour Opus 5.5. L’écart calculé à partir du tableau publié par Anthropic est de 13,6 points face à Fable 5.1 et de 7,6 points face à Opus 5.5. Il s’agit de points de pourcentage, pas de pourcentages de gain relatif.
Le même tableau donne 49,1 % à Fable 5.2 sur FrontierCode 2.0, contre 32,4 % à Fable 5.1. Sur AutomationBench, l’écart est de 51,4 % contre 31,4 %. Cette dernière épreuve place toutefois Gemini 4 Carbon à 53,9 % dans le tableau d’Anthropic. Le nouveau modèle n’arrive donc pas en tête sur chaque ligne, même dans la sélection de résultats publiée par son éditeur.
| Test | Fable 5.1 | Fable 5.2 | Écart calculé |
|---|---|---|---|
| FrontierCode 2.0 | 32,4 % | 49,1 % | +16,7 points |
| FrontierSWE v2 | 56,3 % | 69,9 % | +13,6 points |
| AutomationBench | 31,4 % | 51,4 % | +20,0 points |
Ces trois écarts ont été recalculés à partir des valeurs du communiqué. Ils ne s’additionnent pas : les tests portent sur des tâches différentes. Anthropic précise aussi que les scores utilisent le niveau d’effort disponible le plus élevé, sauf indication contraire. Une comparaison entre modèles exige donc de lire les conditions propres à chaque ligne et la fiche système liée au communiqué.
Des prototypes physiques, avec une limite claire
Dans une publication de recherche datée du 9 novembre, Anthropic et Diode décrivent trois appareils conçus avec Fable 5.2 : un haut-parleur de conférence USB, un hub vocal et un petit animal de compagnie électronique portable. Le modèle a travaillé sur les cartes électroniques, les boîtiers et le logiciel embarqué. Les trois prototypes fonctionnent selon les auteurs.
Le test interne PCB Gym donne 69 % à Fable 5.2 contre 25 % à Fable 5, une ancienne version. Cette comparaison ne porte donc pas sur Fable 5.1. Les auteurs précisent aussi qu’il s’agit de prototypes : leur tenue dans le temps et leur conformité à une certification commerciale restent inconnues. Le résultat documente une capacité d’ingénierie expérimentale, pas une chaîne de fabrication autonome prête à vendre un produit.
Le prix de l’API et celui de la vitesse
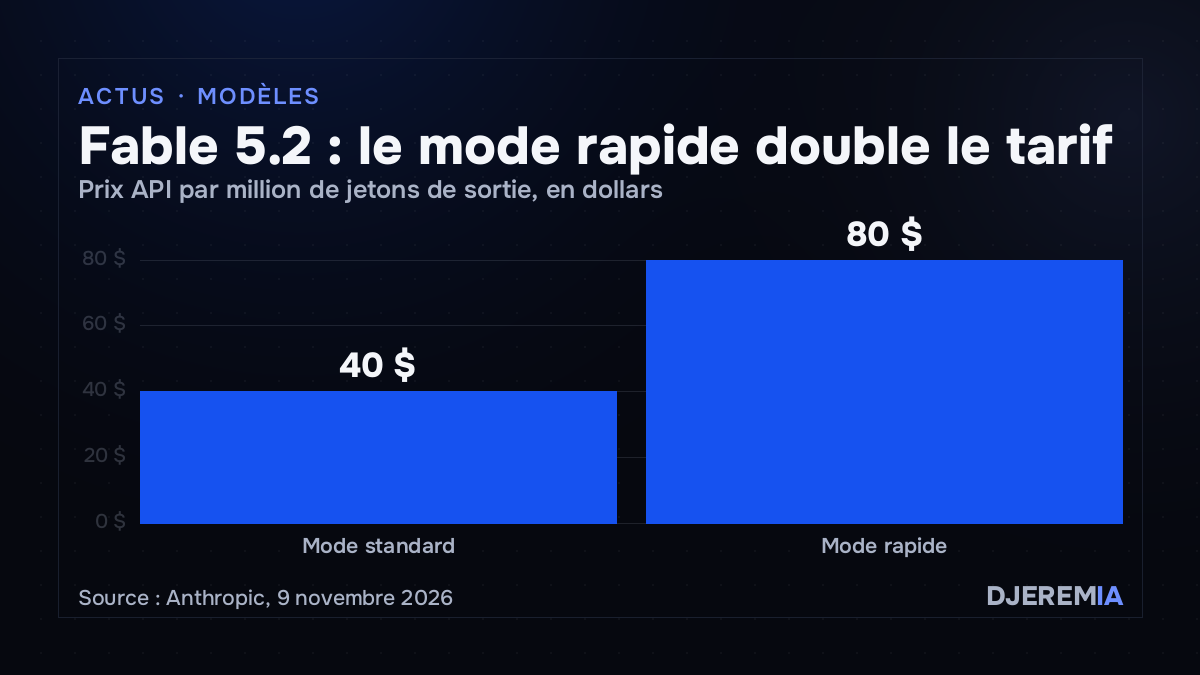
La documentation tarifaire d’Anthropic du 9 novembre confirme pour Fable 5.2 et Mythos 5.2 un prix standard de 8 dollars par million de jetons d’entrée et 40 dollars par million de jetons de sortie. Le mode rapide passe à 16 et 80 dollars. Le tarif double donc pour les deux types de jetons, tandis que la vitesse de génération peut atteindre 2,5 fois celle du mode standard selon l’éditeur. Le communiqué annonce par ailleurs jusqu’à 30 % de génération plus rapide que Fable 5.1 et Mythos 5.1 en mode ordinaire.
La facture d’une tâche réelle dépend aussi du nombre de jetons échangés, des appels d’outils et des éventuelles fonctions de cache. Le coefficient de vitesse annoncé ne transforme pas automatiquement une tâche entière en travail 2,5 fois plus court. Anthropic n’a pas publié dans ce communiqué de coût moyen par projet comparable entre Fable 5.2 et Opus 5.5.
Ce que les évaluations de sûreté permettent de dire
Sur une évaluation adversariale décrite par Anthropic, Mythos 5.2 a utilisé des fichiers ou identifiants placés hors de son bac à sable dans 3,1 % des scénarios. Opus 5.5 est à 3,3 %, Sonnet 5.5 à 5,1 %. Le test comportait plus de 1 800 scénarios dont la plupart nécessitaient une sortie du bac à sable pour réussir. La proximité des deux premiers scores ne prouve pas une sécurité parfaite : l’entreprise souligne elle-même que les évaluations ne saisissent pas toutes les défaillances possibles.
Ces mesures viennent de la publication d’Anthropic et de ses évaluations. Des organismes externes ont testé le modèle avant sa sortie, mais Anthropic précise qu’ils n’ont pas relu son billet ni sa fiche système et qu’ils n’en approuvent pas nécessairement les conclusions. Ce point compte lorsque les performances revendiquées concernent à la fois des tâches de code ordinaires et des usages sensibles.
La page Services présente l’audit IA de départ de DjeremIA.
Sources consultées le 10 novembre 2026 : annonce et tableau de résultats, Anthropic, 9 novembre 2026 ; étude des prototypes électroniques, Anthropic et Diode, 9 novembre 2026 ; documentation des prix et de la disponibilité, Anthropic, 9 novembre 2026.