En bref
- Anthropic a publié le 6 novembre 2026 « The components of agent memory », signé Lance Martin, qui décrit une mémoire d’agent en quatre couches et un processus de consolidation hors session baptisé « dreaming ».
- Sur la tâche base de données du CL-Bench 1.0, la mémoire fait passer Claude Sonnet 5.5 de 0,644 à 0,833 et Claude Opus 5.5 de 0,655 à 0,838. Plusieurs reprises de presse attribuent le premier couple de chiffres à Opus 5.5.
- La fonction existe côté produit : l’API « Dreams » des Managed Agents est en préversion de recherche, sur demande d’accès.
Anthropic a mis en ligne le 6 novembre un long article d’ingénierie consacré à la mémoire de ses agents. Le texte ne présente pas un nouveau modèle. Il expose la manière dont l’entreprise découpe la mémoire de Claude en couches, les évaluations qu’elle a menées pour mesurer l’apport de chacune, et un mécanisme de relecture différée des sessions, le « dreaming », emprunté à la notion de sleep-time compute proposée par Letta et l’université de Berkeley.
Une mémoire en quatre couches
Anthropic définit la mémoire d’agent comme le savoir que Claude tire de son expérience et conserve d’une session à l’autre, sous forme de contexte relisible. La définition exclut explicitement l’entraînement des poids, l’apprentissage dans une même conversation et la compaction, ces résumés qui remplacent les anciens tours d’une conversation trop longue.
Le schéma publié empile quatre niveaux, du plus brut au plus sélectif :
- Les transcriptions, journal d’événements consultable par recherche.
- Les notes de mémoire, écrites par Claude pendant la session sur ce qu’il juge important.
- Les représentations, par exemple un wiki de pages reliées entre elles.
- Le contexte injecté, chargé automatiquement au début de chaque session.
Le dreaming relie ces couches : un passage hors session relit les transcriptions, corrige les notes, construit ou élague les représentations et décide de ce qui remonte dans la couche injectée. L’article rappelle que cette dernière doit rester courte. Claude Code n’en charge que les 200 premières lignes ou 25 Ko du fichier MEMORY.md, qui sert d’index vers le reste.
CL-Bench : les modèles récents ferment la boucle seuls
Premier banc d’essai, une tâche du Continual Learning Bench 1.0 : répondre à une série de questions en interrogeant une base de données, chaque question dans une session neuve, avec pour seul lien un dossier de mémoire persistant. Après chaque réponse, Claude reçoit la solution et peut écrire ce qu’il en retient.
Les valeurs ci-dessous sont lues dans les descriptions des figures de l’article (récompense moyenne, de 0 à 1). L’écart est calculé par nos soins.
| Modèle | Sans mémoire | Avec mémoire | Écart |
|---|---|---|---|
| Claude Opus 5.5 | 0,655 | 0,838 | +0,183 |
| Claude Sonnet 5.5 | 0,644 | 0,833 | +0,189 |
| Claude Opus 5 | 0,564 | 0,828 | +0,264 |
| Claude Opus 4.7 | 0,383 | 0,700 | +0,317 |
| Claude Sonnet 5 | 0,306 | 0,610 | +0,304 |
| Claude Sonnet 4.6 | 0,330 | 0,364 | +0,034 |
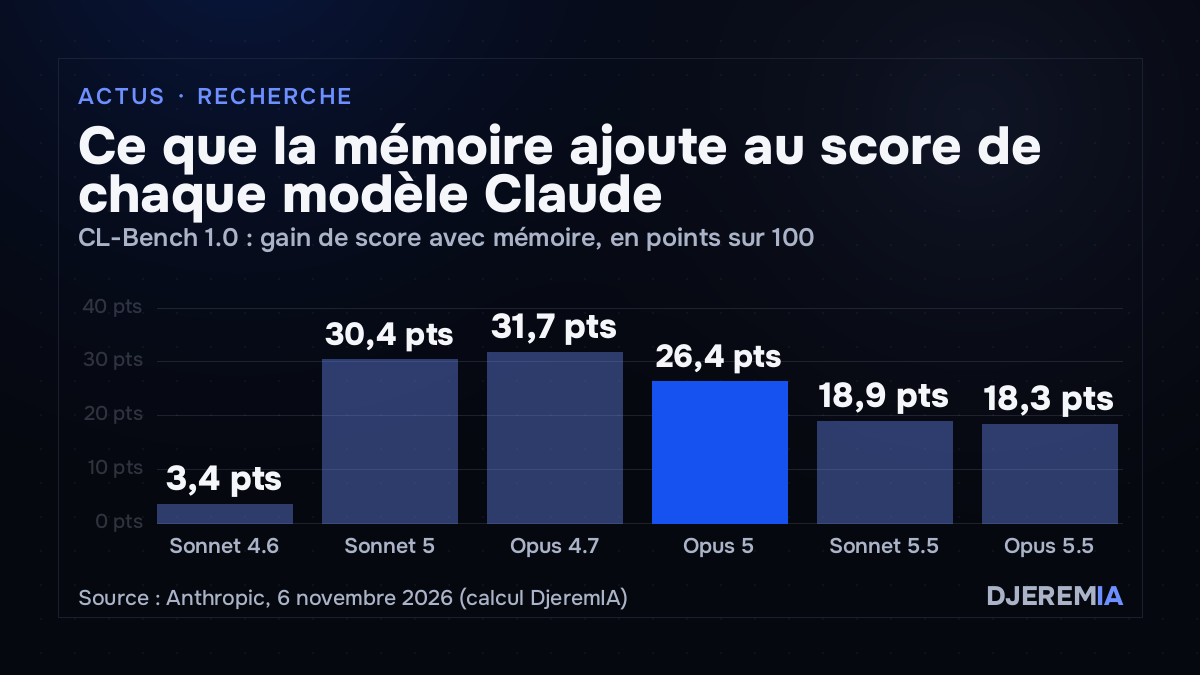
Le texte décrit une progression qualitative. Sonnet 4.6 accumule des hypothèses non testées dans des fichiers épars. Opus 4.7 regroupe ses notes et distingue faits vérifiés et non vérifiés. Opus 5 est présenté comme le premier à « fermer la boucle » : chaque entrée porte une règle, la preuve qui la fonde et les pièges rencontrés. Opus 5.5 et Sonnet 5.5 atteignent un score avec mémoire proche de celui d’Opus 5, mais partent d’une base plus haute, d’où un gain plus faible.
Deux résultats portent sur le pilotage. Imposer une règle fixe, « ne noter que les échecs », réduit le gain apporté par la mémoire de 0,234 pour Opus 5 et de 0,150 pour Opus 4.7. À l’inverse, demander explicitement à Sonnet 4.6 de relire sa mémoire et de tester ses hypothèses porte son score à 0,641, soit presque le double. Sonnet 5 lit sa mémoire avant de répondre neuf fois sur dix sans consigne ; Sonnet 4.6 le fait moins d’une fois sur deux. La conclusion d’Anthropic : expliquer aux modèles récents à quoi sert la mémoire, sans leur dicter quoi y écrire.
Pokémon : 413 fichiers contre 10
Le deuxième banc est la partie de Pokémon Rouge déjà utilisée par Anthropic pour tester les tâches longues. À environ 10 000 actions de jeu, Claude Sonnet 3.7 avait écrit 413 fichiers de mémoire répartis dans 225 dossiers, soit 977 930 caractères, pour un seul badge. Claude Fable 5 en avait écrit dix, dont un fichier global.md servant de tableau de bord, pour 43 406 caractères et quatre badges.
« Si trois balles ou plus échouent d’affilée, VARIER le moment (ajouter des temps d’attente entre les étapes du menu) : la capture a réussi juste après. »
Note écrite par Claude Fable 5 après sept Poké Balls ratées sur un Magikarp, citée en anglais par Anthropic (traduction DjeremIA).
L’écart tient à ce que chaque modèle juge utile. Sonnet 3.7 consignait des informations lisibles à l’écran à chaque tour, comme l’argent ou la position, que le jeu rendait vite obsolètes. Autour de l’action 10 000, il a enchaîné 17 actions consacrées à créer et supprimer des fichiers sans jouer. Fable 5 ne gardait que ce que le jeu ne dit pas : plans, stratégies, règles éprouvées. Selon l’article, Opus 5.5 a adopté la même sobriété et terminé le jeu.
Le dreaming a aussi corrigé une erreur précise. Claude avait noté à tort que le Centre Pokémon du mont Sélénite se trouvait du côté est. Avec cette note, il est retombé trois fois d’une corniche sur la route précédente et n’a jamais atteint Azuria. Après une relecture qui a confronté la note à la transcription, il est revenu dans la grotte et a atteint la ville à l’action 1 935.
Des wikis construits sur 128 sessions
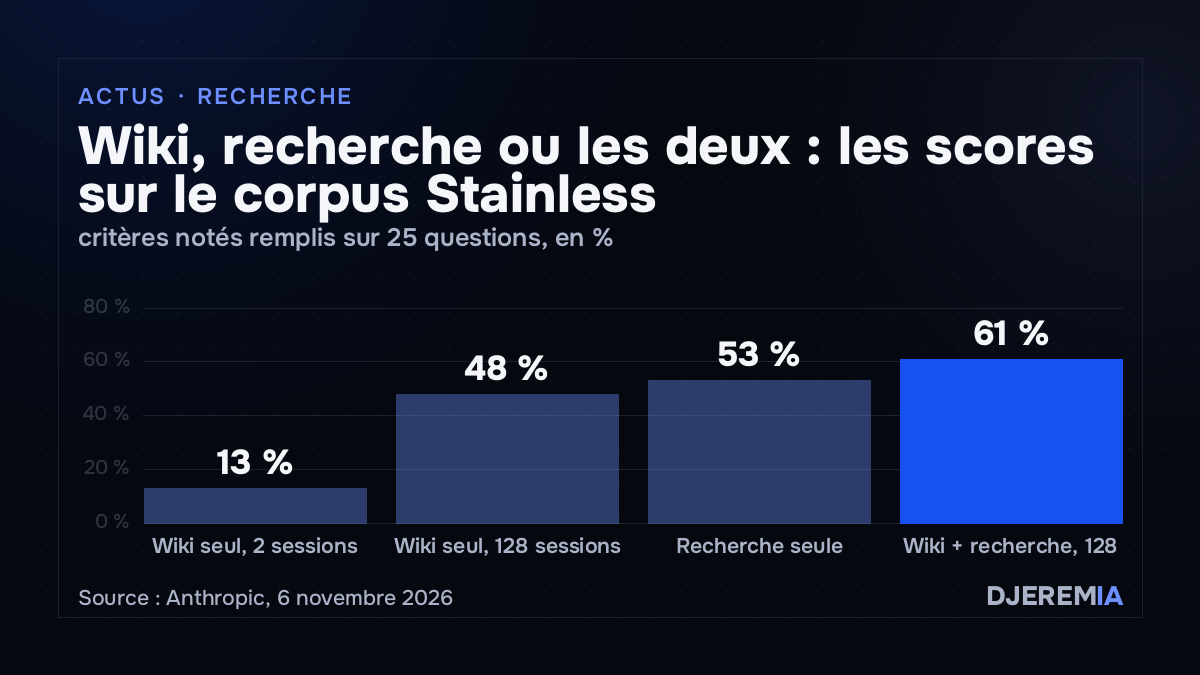
Le test le plus lourd porte sur environ 350 000 fichiers internes, quelque 420 millions de jetons, de Stainless, éditeur logiciel racheté par Anthropic en mai. Des agents Opus 5 ont construit un wiki au fil de 128 sessions coordonnées par un journal partagé, puis répondu à 25 questions.
Avec le wiki seul, la part des critères notés remplis passe de 13 % après deux sessions à 48 % après 128. Avec le wiki et l’outil de recherche, elle monte de 54 % à 61 %, contre 53 % pour la recherche seule, avec une économie d’environ 20 000 jetons par question. Le wiki compte alors 222 pages et 12 893 liens, contre 103 pages et 766 liens au départ.
Les autres essais, menés sur le benchmark juridique LAB de Harvey, nuancent ce résultat. Sur 24 questions relatives à une fusion, dont plus de la moitié exigent de croiser plusieurs documents, Claude obtient 87 % avec le wiki contre 73 % avec la recherche seule. Sur une tâche où chaque critère se trouve dans un seul document, le wiki n’apporte pas de gain net. Sur une autre, il a atteint 203 Ko pour un corpus de 115 Ko, 1,77 fois sa taille, ce que l’auteur compare à la carte à l’échelle de l’empire imaginée par Borges.
Les consignes de construction pèsent aussi. Quand quatre agents écrivaient dans une même page de clauses contractuelles, les enregistrements s’écrasaient et seuls 41 faits notés sur 57 survivaient. Avec une page par contrat et des clauses citées mot pour mot, consigne réécrite par Claude après analyse de ses propres échecs, les 57 étaient présents.
Une préversion côté produit et des questions ouvertes
La documentation de l’API Dreams décrit une tâche asynchrone qui prend un magasin de mémoire existant et de 1 à 100 transcriptions de sessions, puis produit un nouveau magasin dédoublonné et réorganisé, sans modifier l’original. La fonction est en préversion de recherche, sur demande d’accès, compatible avec les modèles de Claude Sonnet 4.6 à Claude Fable 5.1, et non éligible à la conservation zéro des données. Un guide du Claude Cookbook et un exemple de wiki de connaissances accompagnent l’article.
Les limites de l’étude
- Les résultats Pokémon comparent une seule partie par modèle, ce qui ne permet pas de mesurer la variance.
- Les évaluations sont internes et n’ont pas été reproduites par un tiers.
- Le dreaming consomme du calcul, et Anthropic reconnaît ne pas savoir à quelle fréquence le lancer ni quelles mémoires vérifier en priorité.
L’article laisse aussi ouverte la question de fond : bâtir la mémoire sur des représentations entretenues ou simplement sur la recherche dans les transcriptions, dont les résultats sur le corpus Stainless montrent qu’elle reste un socle difficile à battre.
La formation Mémoire IA de DjeremIA dispose d’une page dédiée.