Anthropic a publié le 22 octobre un guide d’architecture qui prend le contre-pied d’une pratique répandue chez les entreprises : multiplier les sous-agents spécialisés, chacun confié à une équipe, sous un orchestrateur central. Son équipe Applied AI y écrit qu’« un agent unique avec des skills » a « fréquemment » fait mieux, sur la qualité, que le prompt unique fourre-tout comme que la conception à sous-agents, et souvent pour un coût et une latence par tâche plus faibles. Le texte, signé Diane Sarkis, s’accompagne d’un kit de migration publié sur GitHub sous licence Apache 2.0. Il a circulé plus largement à partir du 25 octobre, après sa reprise par The Decoder.
Ce que dit le guide
Le point de départ est un constat de terrain. L’équipe Applied AI, qui accompagne les déploiements d’agents chez les grands comptes d’Anthropic, dit avoir observé un « schéma » : des entreprises qui ont gagné à intégrer dans la boucle principale leurs routeurs, leurs planificateurs et leurs sous-agents métier. Un exemple est donné sans nom de client : une entreprise dont l’agent destiné aux clients comptait une douzaine de sous-agents spécialisés avait du mal à garder une expérience cohérente avec sa marque, et la latence ajoutée dégradait l’usage.
Le guide décrit aussi une progression qu’Anthropic dit voir souvent dans les projets qui lui sont soumis : un classifieur d’intention, une chaîne de raisonnement en plusieurs étapes fixes, des segments d’utilisateurs, des branches de recommandation séparées et un orchestrateur multi-agents au sommet. Selon l’entreprise, l’essentiel de cette structure fait un travail dont le modèle n’a plus besoin, et « un prompt système clair, quatre ou cinq outils de données légers et des garde-fous de sortie fermes » couvriraient la plus grande partie du cas d’usage.
La loi de Conway appliquée aux agents
Le diagnostic porte autant sur l’organisation que sur la technique. Quand chaque équipe construit son propre agent et qu’une équipe plateforme ajoute un orchestrateur par-dessus, l’architecture finit par reproduire l’organigramme, ce que le guide rattache explicitement à la loi de Conway. Anthropic en liste les effets : des détails perdus à chaque passage de relais entre agents, des centaines de sous-agents qui se recoupent sans standard ni responsable identifié, un prompt système où chaque équipe ajoute sa phrase jusqu’à produire des règles contradictoires (le texte parle de « Frankenprompt »), et des évaluations trop locales, optimisées pour une sous-tâche, sur lesquelles la direction finit par décider.
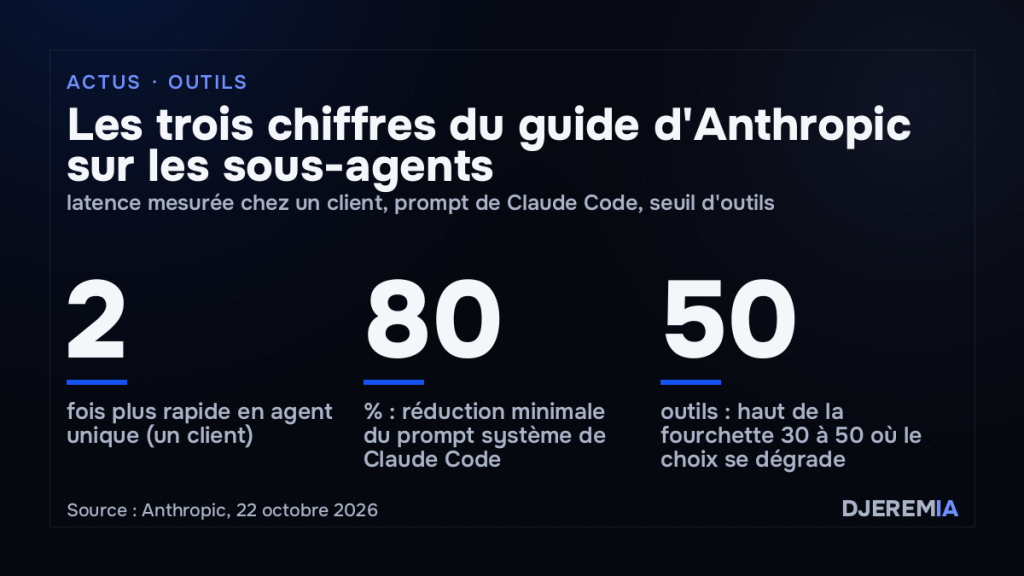
Le seul chiffre de performance avancé concerne la latence : un client qui a comparé son harnais multi-agents à une boucle d’agent unique a mesuré une exécution « environ deux fois plus rapide » avec la seconde. Anthropic ne publie ni le nom de ce client, ni la nature des tâches, ni le détail de la comparaison, ce qui en limite la portée.
Pourquoi Anthropic change de discours
Anthropic a elle-même popularisé l’architecture orchestrateur et sous-agents, notamment avec son système de recherche multi-agents, auquel le guide renvoie. Le texte avance trois raisons au changement de recommandation. D’abord, un contexte partagé produirait de meilleures réponses : un agent qui a vu le résultat de chaque étape peut les relier, là où des sous-agents ne rendent que des résumés. Ensuite, le chargement progressif du contexte (des descriptions courtes de skills et d’outils, chargées en entier seulement quand elles servent, via les skills et la recherche d’outils) supprime la principale raison qui poussait à découper le travail. Anthropic indique avoir ainsi réduit de plus de 80 % le prompt système de Claude Code pour ses modèles les plus avancés.
Enfin, les modèles auraient progressé. Le guide situe le tournant à Opus 4.5 et rappelle que la réflexion ne peut plus être désactivée sur Opus 5.5 et Fable 5.1. Les modèles récents commentent leur avancement et vérifient leur propre travail, ce qui rendrait redondantes certaines couches de contrôle du harnais. Anthropic ajoute que, lors des migrations de modèle menées avec des clients, les structures multi-agents rigides étaient souvent ce qui empêchait le nouveau modèle d’assumer davantage de travail.
L’architecture cible
La conception visée tient en une boucle : un modèle, une fenêtre de contexte, des appels d’outils exécutés en parallèle à chaque tour, des limites fixées par le harnais (budget de tours et de coût, validation avant écriture). Le modèle écrit son plan au premier tour et le révise à mesure que les résultats arrivent. C’est, selon le guide, la principale différence avec l’orchestrateur : le modèle qui planifie est aussi celui qui exécute, et peut donc modifier le plan en cours de route.
Le savoir-faire des équipes migre vers deux supports. Les skills portent la procédure, les étapes et les arbitrages qu’un prompt de sous-agent contenait. Les outils MCP servent aux actions, aux lectures de données en direct et aux contrôles bloquants, y compris les droits par utilisateur : chaque outil vérifie ce que l’appelant peut voir et renvoie un refus lisible par le modèle. Le guide recommande de regrouper les outils par intention de l’utilisateur plutôt que d’en créer un par API, car au-delà de 30 à 50 définitions d’outils dans le prompt système, le choix de l’outil « tend à se dégrader ». Une petite équipe centrale garde la main sur le prompt système, la qualité de bout en bout et la validation de chaque nouvel outil ou skill.
Les cas où les sous-agents restent justifiés
Le texte ne condamne pas les sous-agents. Il retient trois situations où ils restent pertinents : une boucle unique qui subit une dégradation mesurable liée à l’encombrement du contexte, des tâches à mener en parallèle dans des fenêtres neuves que l’on jette une fois le travail fait, et un agent qui peine à choisir ses outils ou reçoit des instructions contradictoires. Pour ceux qui gardent une architecture multi-agents, la consigne est de découper par contexte (un morceau de travail qui dépend peu du reste et rend un résultat compact, comme une piste de recherche indépendante ou une vérification en boîte noire) et non par type de problème, faute de quoi les agents se livrent à un « jeu du téléphone » où chaque relais dégrade l’information.
La migration proposée est progressive : construire d’abord un petit jeu d’évaluations de bout en bout (dix exemples de référence suffiraient pour commencer), appeler les sous-agents comme des outils, puis les replier un par un sous forme de skills et d’outils, en ne gardant un sous-agent que si la version repliée fait moins bien. Anthropic signale un piège rencontré sur un agent de support de démonstration : la fusion a réduit la latence mais cassé un processus qui fonctionnait, l’agent répondant seul avec l’outil de suivi de commande au lieu de consulter le spécialiste de la livraison. La régression n’est apparue qu’une fois sur deux exécutions, d’où la recommandation de lancer chaque tâche plusieurs fois.
Le kit de migration
Le dépôt single-agent-loop-kit enchaîne des skills de l’API Claude dans un parcours guidé, avec une démonstration sur un système fictif. Le guide en décrit quatre : build-eval pour créer les évaluations, prompt-audit pour repérer dans les prompts, skills et descriptions d’outils les instructions écrites pour des modèles plus anciens, hillclimb pour améliorer itérativement une application face à une évaluation existante, et cost-optimize pour proposer des économies (cache de prompt, réduction des jetons, niveau d’effort, choix du modèle). Ces outils sont publiés par l’éditeur des modèles concernés, qui a un intérêt direct à ce que ses clients confient davantage de travail à un seul modèle plus capable.
Le guide se termine sur une réserve : les bonnes pratiques évoluent avec les modèles, et le principe compte davantage que l’architecture du moment, à savoir mesurer, changer une chose à la fois et garder ce qui tient. Le fonctionnement des sous-agents dans Claude Code est détaillé dans notre guide sous-agents Claude Code, et celui des skills dans skills Claude Code.
L’automatisation IA sur mesure figure parmi les services de DjeremIA.
Sources : Anthropic, « Building agents: When to fold subagents into your main agent loop », 22 octobre 2026 ; dépôt single-agent-loop-kit ; The Decoder, 25 octobre 2026.