Anthropic a publié le 28 septembre 2026 Claude Sonnet 5.5, deuxième modèle de la famille Claude 5.5 après Opus 5.5, sorti six jours plus tôt. Le tarif ne bouge pas par rapport à Sonnet 5. L’éditeur annonce une génération plus rapide d’au moins 30 %, une consommation de tokens nettement plus faible et des scores qui, sur plusieurs tests, arrivent au niveau de son modèle haut de gamme.
Un prix identique, une facture annoncée en baisse
Sonnet 5.5 est facturé 2 dollars par million de tokens en entrée et 10 dollars en sortie, 0,20 dollar pour les lectures de cache et 2,50 dollars pour les écritures de cache, selon la grille publiée par Anthropic. C’est exactement le prix de Sonnet 5, et la moitié de celui d’Opus 5.5 (4 et 20 dollars). L’inférence limitée aux États-Unis coûte 1,1 fois ce tarif.
La baisse de coût revendiquée ne vient donc pas du prix unitaire, mais du nombre de tokens nécessaires pour une tâche. Anthropic parle d’un coût par tâche « jusqu’à 30 % inférieur » à celui de Sonnet 5 pour la plupart des usages. Parmi les clients cités par l’éditeur, le fonds Balyasny indique qu’une réponse sur sa batterie interne de 2 441 tâches financières a consommé environ 121 000 tokens avec Sonnet 5.5, contre 497 000 avec Sonnet 5. Ces témoignages sont choisis par Anthropic et ne sont pas vérifiables de l’extérieur.
Des scores proches d’Opus 5.5, mesurés par Anthropic
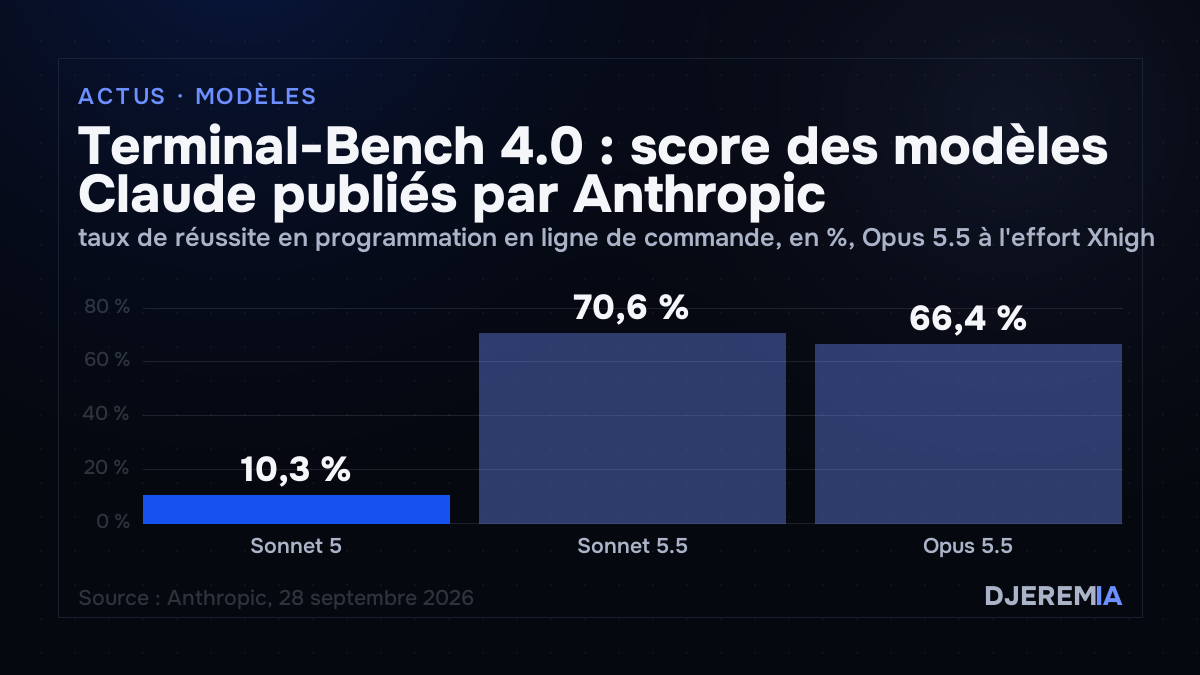
Le tableau publié compare Sonnet 5.5, Sonnet 5, Opus 5.5 et, quand les chiffres existent, GPT-6 Sol d’OpenAI. L’écart le plus spectaculaire porte sur Terminal-Bench 4.0, un test de programmation en ligne de commande : 70,6 % pour Sonnet 5.5 contre 10,3 % pour Sonnet 5. Opus 5.5 y est crédité de 66,4 %, mais à l’effort « Xhigh », son meilleur réglage.
- CursorBench 4.0 (tâches tirées de vraies sessions de l’éditeur Cursor) : 55,5 % contre 34,1 % pour Sonnet 5 et 57,8 % pour Opus 5.5.
- OSWorld 2.1 (utilisation d’un ordinateur) : 80,1 %, contre 57,0 % et 81,8 %.
- Humanity’s Last Exam, avec outils : 64,5 %, contre 54,9 % et 67,7 %.
- GDPval-AA v2.1 (tâches professionnelles dans 44 métiers, score Elo mesuré par Artificial Analysis) : 1844, contre 1449 pour Sonnet 5, 1846 pour Opus 5.5 et 1487 pour GPT-6 Sol.
Plusieurs réserves figurent dans l’annonce elle-même. Pour Terminal-Bench et CursorBench, OpenAI n’a pas publié de score de GPT-6 Sol : Anthropic compare donc avec GPT-5.6 Sol sur ses graphiques. Artificial Analysis a testé une version de préproduction qui présentait un bogue sur les sorties structurées, corrigé depuis. Et Anthropic écrit que les benchmarks ne montrent qu’une facette du modèle : dans ses propres essais comme chez les testeurs externes, Opus 5.5 reste « clairement plus fort » sur le travail complexe et ouvert qui demande un jugement soutenu.
Le niveau d’effort, variable centrale
Comme Opus 5.5, Sonnet 5.5 se règle par niveau d’effort, de Low à Max. Le réglage par défaut est Medium dans les applications Claude et dans Claude Code, High sur la plateforme développeurs. Selon Anthropic, Sonnet 5.5 en effort Low ou Medium dépasse sur plusieurs tests le meilleur score de Sonnet 5 pour environ un dixième du coût par tâche.
Monter l’effort ne garantit pas un meilleur résultat. Sur FrontierCode, qui mesure si une modification de code serait fusionnée sans retouche, Sonnet 5.5 obtient un score plus bas en Max qu’en Xhigh : Anthropic explique qu’à ce niveau le modèle lançait plus souvent la revue de code de Claude Code, répartie entre de nombreux sous-agents, ce qui a provoqué des dépassements de délai ou des modifications hors périmètre. Le développeur Simon Willison rapporte un problème voisin : en effort Max, sa requête de test a consommé 128 000 tokens de réflexion (1,28 dollar) sans produire de résultat, le même défaut qu’il avait relevé sur Opus 5.5. En Xhigh, la même requête a abouti en 41 secondes pour 5,74 centimes.
Des garde-fous jusque-là réservés aux gros modèles
Anthropic estime que les capacités de Sonnet 5.5 en cybersécurité sont comparables à celles d’Opus 5. C’est le premier Sonnet lancé avec des protections de ce type : les tâches de cybersécurité jugées à haut risque basculent de façon visible vers Sonnet 5, la recherche et la correction de bogues courantes restant possibles. Les protections en biologie sont celles de Sonnet 5.
Le modèle est aussi le premier Sonnet doté de classifieurs contre la distillation, c’est-à-dire l’extraction de ses raisonnements à grande échelle par des comptes factices. Sa réflexion est désormais liée au compte qui l’a produite. Anthropic prévient que les conversations déplacées d’un compte à l’autre, y compris un changement de compte en pleine session Claude Code, sont concernées. Les développeurs qui utilisaient Sonnet sans réflexion doivent passer au nouveau paramètre between_tools avant la migration.
Sur l’audit comportemental automatisé d’environ 1 850 scénarios, Sonnet 5.5 égale ou dépasse Sonnet 5 sur la plupart des mesures d’alignement. Opus 5.5 reste légèrement meilleur sur l’ensemble de l’audit.
Disponibilité
Sonnet 5.5 est accessible sur Claude.ai (web, iOS, Android), par l’API sous l’identifiant claude-sonnet-5-5, ainsi que sur AWS, Google Cloud et Microsoft Foundry. D’après Simon Willison, c’est désormais le modèle proposé aux utilisateurs gratuits de Claude.ai. Anthropic confirme que Haiku 5.5, le troisième modèle de la famille, destiné aux usages à fort volume, arrivera « dans les semaines à venir », sans date ni prix. Le site tient par ailleurs un comparatif des modèles par tâche.
Le coût de Sonnet 5.5 et d’Opus 5.5 dans Claude Code, par abonnement ou à l’usage, est détaillé dans le guide des prix de Claude Code.
Quel modèle mettre sur quelle tâche de ton activité, et pour quel coût réel : c’est ce que tranche l’audit et cadrage IA.