Moonshot AI a mis en service le 23 octobre Kimi K3.1 Pro, nouvelle version de son modèle phare. Disponible dès maintenant par l’API et dans les applications Kimi, il doit devenir un modèle à poids ouverts : l’éditeur chinois s’engage à publier les poids complets d’ici le 4 novembre 2026. Les premières mesures indépendantes le placent tout près des modèles fermés les plus performants.
Ce que Moonshot annonce
Dans son billet technique, Moonshot présente K3.1 Pro comme le premier modèle de la série K3.1 et son modèle à poids ouverts le plus capable de la classe des 3 000 milliards de paramètres. Il s’agit d’une version de Kimi K3 post-entraînée avec un budget de calcul nettement plus élevé, principalement en apprentissage par renforcement sur « des centaines de domaines ». La fenêtre de contexte atteint un million de jetons.
Une variante Highspeed, deux à trois fois plus rapide selon l’éditeur, est lancée en parallèle. Les deux modèles sont accessibles sur Kimi.ai, dans Kimi Work, dans l’outil de programmation Kimi Code et par l’API, sous les identifiants kimi-k3.1-pro et kimi-k3.1-pro-highspeed. Moonshot propose la non-conservation des données aux clients de l’API. Côté entreprise, l’accès est désactivé par défaut et doit être activé par l’administrateur.
Des scores déclarés au niveau des modèles fermés
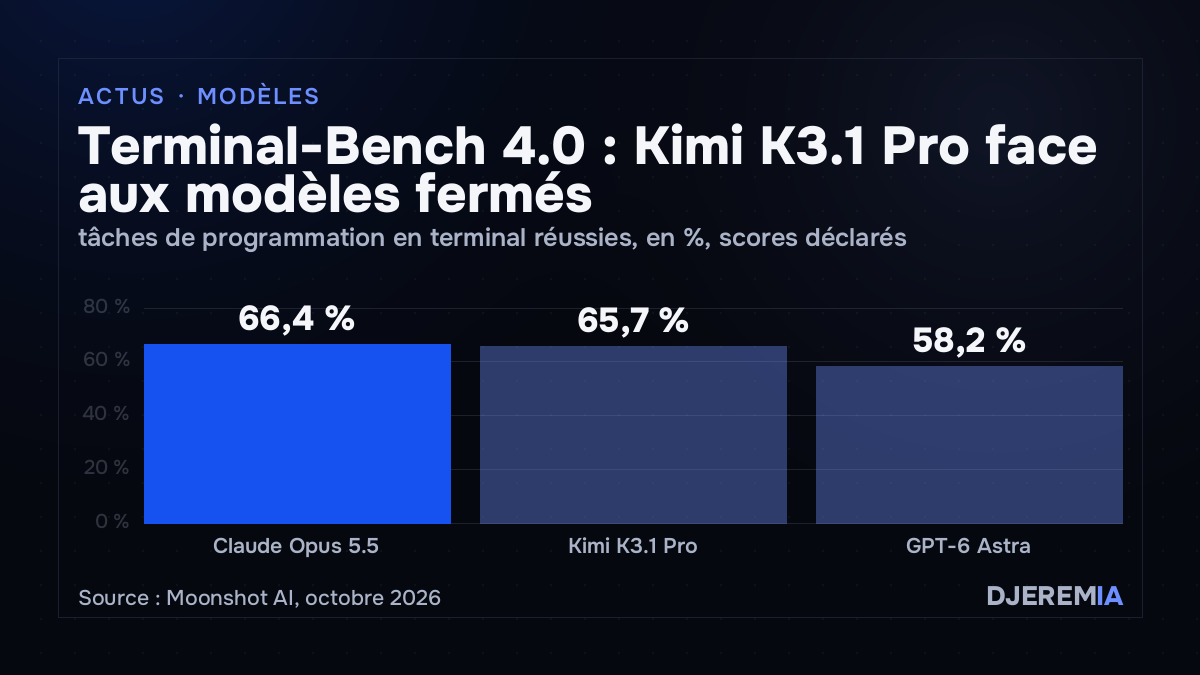
Les résultats publiés par Moonshot ont été obtenus avec l’effort de raisonnement réglé au maximum. Sur Terminal-Bench 4.0, qui évalue des agents de programmation sur des tâches en terminal, K3.1 Pro obtient 65,7 %, contre 58,2 % pour GPT-6 Astra et 66,4 % pour Claude Opus 5.5. Sur BenchCAD, un test de reconstruction 3D par génération de code CAO, il atteint 92,7 % avec outils, en dessous de Claude Opus 5.5 (96,2 %) et de GPT-6 Astra (95,9 %). Sur OfficeQA Pro v2, consacré à l’analyse de documents financiers, l’éditeur revendique le meilleur résultat publié, avec 64,4.
Ces chiffres viennent de l’éditeur, qui précise avoir évalué son modèle avec le harnais de Claude Code sur plusieurs tests de programmation. Une mesure externe va toutefois dans le même sens : Artificial Analysis attribue à K3.1 Pro un indice d’intelligence de 55, au quatrième rang sur 215 modèles. Selon Simon Willison, ce score le place devant Claude Fable 5.1, GPT-6 Astra et Gemini 4 Argon (53 chacun), et seul Claude Opus 5.5 fait mieux, avec 58. Il note que c’est la première fois qu’un modèle appelé à devenir ouvert atteint ce niveau face aux modèles de pointe.
Le même classement relève deux limites : le modèle est plus lent que la moyenne (environ 73 jetons par seconde en sortie) et très bavard, avec 150 millions de jetons produits pour passer la batterie de tests, contre une médiane de 87 millions.
Un tarif aligné sur le milieu de gamme
Facturé à l’usage, K3.1 Pro coûte 2 dollars par million de jetons en entrée et 10 dollars en sortie, d’après Artificial Analysis et Simon Willison. C’est le même tarif que GPT-6.1 Sol et la moitié de celui de Claude Opus 5.5. La version Highspeed est facturée deux fois plus cher, sauf pour les entrées lues en cache. Artificial Analysis évalue à 2,11 dollars le coût moyen d’une tâche de son indice avec ce modèle.
Moonshot a par ailleurs annoncé, sur sa page de tarification, que les modèles de la série K2 ne seront plus proposés aux nouveaux inscrits à partir du 31 octobre et seront retirés d’ici fin décembre 2026.
Des capacités offensives volontairement réduites avant l’ouverture
La partie la plus détaillée du billet concerne la cybersécurité. Moonshot explique avoir constaté que les capacités de recherche de vulnérabilités progressaient avec le post-entraînement, parce que des contenus liés à la sécurité informatique figuraient dans le corpus général et dans les environnements d’apprentissage. Pour la version à poids ouverts, l’éditeur dit avoir identifié et retiré ces données aux deux étapes de l’entraînement.
Il chiffre l’effet sur un test interne, xdev-bench-hard, qui demande d’écrire un exploit fonctionnel à partir de failles récemment divulguées (noyau Linux, Node.js, Exim, entre autres) : la version entraînée sans ce filtrage résout 90,5 % des problèmes en trois essais, la version publiée 81 %. Moonshot reconnaît que le modèle reste en net progrès sur son prédécesseur dans ce domaine et affirme qu’il demeure en retrait des modèles fermés disponibles depuis au moins trois mois. Sa doctrine affichée : ne pas publier de poids qui repousseraient la frontière absolue des capacités offensives, tout en relevant progressivement le niveau disponible en ouvert.
Ces affirmations ne sont pas vérifiables de l’extérieur à ce stade : le test est interne et les poids ne sont pas encore disponibles.
Ce qui reste à confirmer
Deux points restent ouverts. Le premier est la licence : le billet promet les poids complets d’ici le 4 novembre sans préciser les conditions de réutilisation, alors que Kimi K2, par exemple, avait été diffusé sous une licence MIT modifiée. Le second est l’usage pratique : un modèle de cette taille demande une infrastructure de calcul importante, et son caractère « ouvert » profitera d’abord aux hébergeurs et aux entreprises capables de le faire tourner.
D’ici là, K3.1 Pro est classé comme modèle propriétaire par Artificial Analysis, faute de poids publiés. La comparaison avec les modèles fermés américains, sur des tests indépendants plutôt que sur les tableaux de l’éditeur, dira si l’écart annoncé tient.
La page Services présente l’audit IA de départ de DjeremIA.