L’organisme d’évaluation indépendant METR a publié le 5 novembre 2026 son évaluation de l’accélération de la recherche et développement (R&D) en IA chez Anthropic. Sa conclusion : en octobre 2026, Anthropic améliore probablement les capacités de ses modèles sur des tâches bien définies environ deux fois plus vite qu’entre mars 2024 et octobre 2025, avec une fourchette jugée plausible de 1,3 à 3 fois. METR attribue la majorité de cette accélération, autour de 80 %, à l’usage de l’IA par les équipes elles-mêmes. Le rapport précise aussi qu’Anthropic a retiré de la version publique la plupart des éléments qui ont le plus pesé dans ce jugement.
Onze semaines dans les données internes
Entre le 12 août et le 29 octobre, l’équivalent de 2,5 salariés à temps plein de METR a travaillé sur des appareils d’Anthropic, avec accès à des scores de benchmarks de modèles internes non publiés, à des historiques d’efficacité algorithmique en préentraînement et en apprentissage par renforcement, aux effectifs, aux volumes de code, aux dépenses d’inférence des agents et à une quinzaine d’entretiens avec des chercheurs. METR indique ne pas avoir été payé et ne pas avoir eu accès aux modèles non publiés eux-mêmes. L’organisme juge l’accès « sans précédent » et supérieur à ses attentes, tout en notant qu’il n’avait pas l’accès d’un salarié : Anthropic validait ou refusait chaque demande de données.
Le travail répond à trois questions :
- le rythme de progrès des capacités internes a-t-il accéléré ;
- quelle part de cette accélération revient à l’IA ;
- des goulets d’étranglement peuvent-ils freiner la suite à court terme.
Anthropic suit cet indicateur dans sa politique de passage à l’échelle responsable (RSP), qui fixe un seuil d’alerte à un doublement du rythme de progrès lié à l’automatisation de la R&D.
Le chiffre central : 1,9 fois le rythme historique
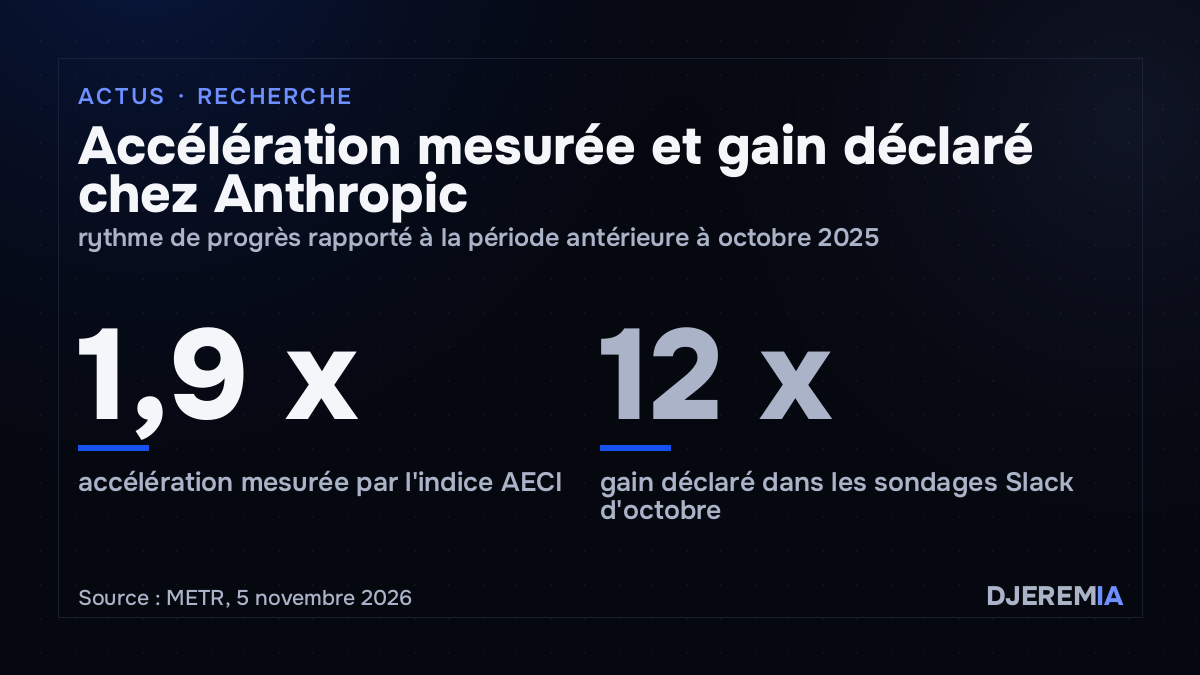
La mesure la plus solide que METR a pu rendre publique est l’AECI, la version interne chez Anthropic de l’indice de capacités d’Epoch AI, qui agrège des scores de benchmarks. Depuis octobre 2025, cet indice progresse 1,9 fois plus vite qu’auparavant, avec un intervalle de confiance à 95 % de 1,5 à 2,8. Dit autrement, Anthropic aurait fait en un an autant de progrès sur ces benchmarks qu’entre octobre 2023 et octobre 2025, soit à peu près le chemin de Claude 2.1 à Sonnet 4.5.
Ce chiffre dépasse le 1,7 publié dans la fiche technique de Haiku 5.5, parce que METR a intégré des modèles internes plus récents. Les tests de robustesse donnent des valeurs entre 1,1 et 2,9 selon les choix de benchmarks, de dates et de modèles retenus. METR se dit en revanche « confiant » sur un point : l’accélération ne vient pas d’une hausse plus rapide du calcul d’entraînement. Le détail de cette preuve a été caviardé.
Le rapport met en garde contre une lecture trop directe des chiffres de productivité individuelle. Dans des sondages internes sur Slack, où les salariés votent par réaction sur le gain apporté par le dernier modèle, le gain déclaré atteint 12 fois en octobre 2026. METR considère ces réponses comme des indices « très lâches », données sans réflexion approfondie, et rappelle qu’un gain individuel ne se traduit pas en accélération globale : celle-ci dépend de la croissance des intrants, pas de leur niveau.
Ce qui a été caviardé
Le contrat donnait à Anthropic un droit de caviardage unilatéral sur toute information non publique. METR, de son côté, pouvait dire si ce droit avait été utilisé et si ses conclusions en dépendaient. Il l’a été largement. Anthropic justifie ces retraits par la volonté d’écarter des informations confidentielles « qui pourraient accélérer d’autres développeurs d’IA ». Le rapport complet fait une centaine de pages ; la version publique résume ce qui a pu en sortir.
| Type d’information | Transmise à METR | Résultats publiés |
|---|---|---|
| Scores de benchmarks des modèles internes | Oui | Oui |
| Mesures intermédiaires clés des capacités | Oui | Non |
| Estimations du progrès algorithmique | Oui | Non |
| Preuves de la contribution de l’IA | Oui | En partie |
| Mesures des principaux intrants de la R&D | En grande partie | Non |
| Goulets d’étranglement et prévisions | En partie | Non |
| Entretiens avec les salariés | Oui | En partie |
Tableau traduit du rapport de METR du 5 novembre 2026.
Le calendrier publié montre que les consignes se sont durcies en fin de parcours. Anthropic a transmis ses règles de caviardage le 25 octobre, puis les a resserrées du 27 au 29 octobre, ce qui a conduit les deux parties à repousser la publication d’environ cinq jours. METR reconnaît la conséquence : le public doit s’en remettre à son jugement « bien plus qu’il ne serait idéal ». Un autre volet a disparu en cours de route. Le contrat prévoyait de vérifier la répartition du calcul entre capacités et sécurité ; Anthropic l’a retiré du périmètre avant toute conclusion, en indiquant vouloir y revenir plus tard.
Onze chercheurs, onze lectures
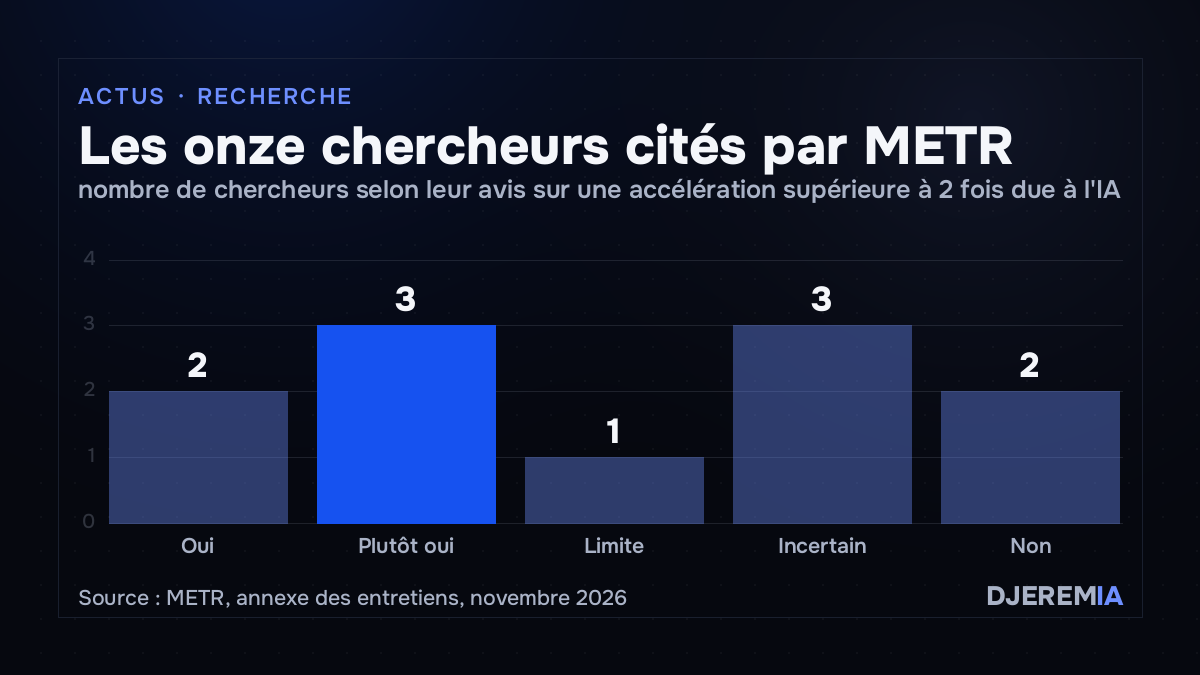
En annexe, METR publie un tableau des citations d’entretiens, classées par Claude selon que chaque chercheur soutient ou non une accélération supérieure à 2 fois due à l’IA dans son domaine. Le décompte des onze lignes est moins uniforme que la conclusion générale : deux « oui », trois « plutôt oui », un cas « limite », trois « incertain » et deux « non ».
Les avis favorables décrivent surtout la disparition du coût d’implémentation. Un chercheur parle d’une réduction d’environ 80 % du temps entre l’idée et l’expérience ; un autre dit ne plus être limité que par les idées et le calcul. Les deux avis contraires désignent les recrutements comme premier facteur. L’un d’eux estime que 15 à 20 % du changement vient de l’IA et dit ne pas croire aux gains de productivité déclarés.
« Avant Opus 4.5, Claude n’était pas utile pour du code autonome. Opus 4.5 a été la première fois où il l’était. Mythos Preview, avec [un outillage d’agents], a été la première fois où il l’était pour des expériences autonomes. »
Un chercheur d’Anthropic, notes d’entretien citées par METR (traduction DjeremIA)
METR retient que l’IA accélère la R&D surtout comme assistance, pas encore par des contributions entièrement autonomes aux étapes les plus importantes de l’entraînement, tout en relevant des « signes de vie » en ce sens.
Pas de frein identifié pour les douze prochains mois
Sur les goulets d’étranglement, l’organisme n’a pas trouvé de limite significative du côté du progrès algorithmique, du calcul d’entraînement, du calcul d’expérimentation ou des données dans les douze prochains mois. Il précise que sa compréhension a changé plusieurs fois au fil des informations reçues et qu’il n’est pas sûr de son évaluation. C’est ce point qui l’amène à juger « significatif » le risque que de nouveaux progrès produisent une accélération encore plus forte.
Les limites listées vont dans les deux sens. L’accélération serait sous-estimée si la croissance devenait hyperbolique, ce que des éléments caviardés rendent plausible selon METR, ou si l’automatisation arrivait plus vite que prévu. Elle serait surestimée si des facteurs sans lien avec l’IA comptaient davantage, si l’AECI favorisait trop les tâches vérifiables, ou si le rythme d’Anthropic entre 2023 et 2025 était anormalement bas.
METR publie le même jour une relecture de la section R&D du rapport de risques d’août 2026 d’Anthropic. Il y partage l’idée d’un risque catastrophique faible pour les modèles du 15 juillet, mais juge « plausible » que le seuil d’alerte du doublement ait déjà été franchi, et estime que le rapport public d’Anthropic sous-estime l’accélération en cours. Les chercheurs de METR et ceux d’Anthropic penchent tous deux vers un seuil non franchi. Le rapport principal est consultable sur le site de METR.
Les formations sur l’IA de DjeremIA sont présentées dans une rubrique distincte.