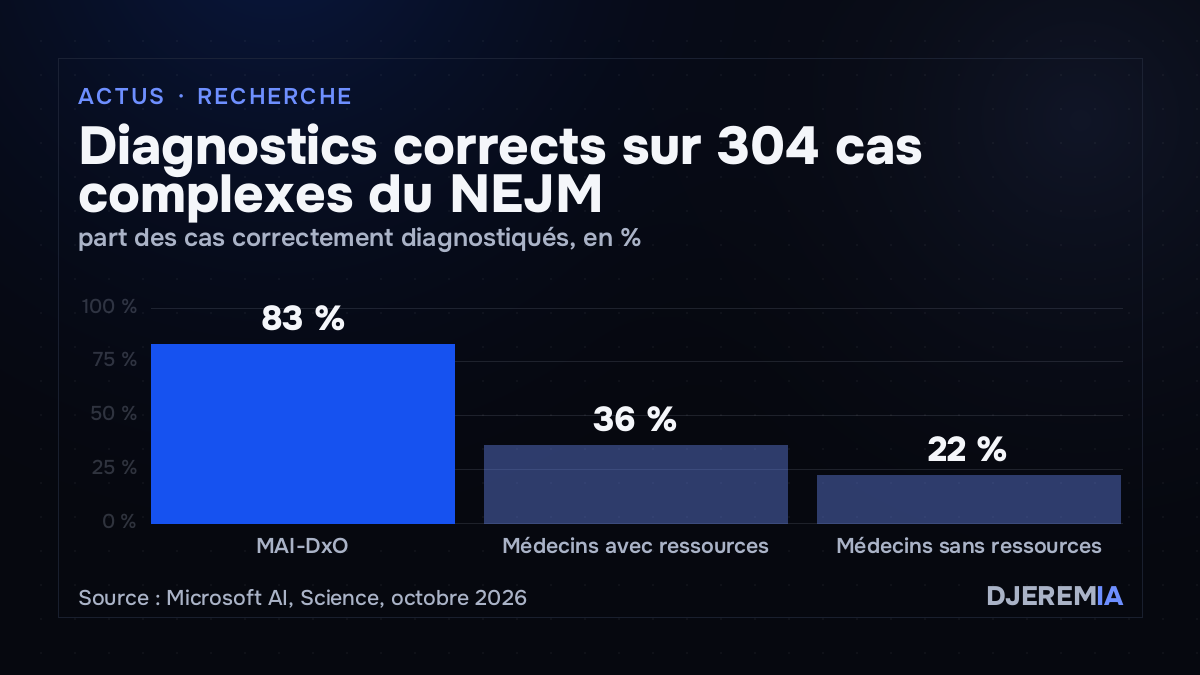
Microsoft AI a publié le 22 octobre 2026 dans la revue Science les résultats de MAI-DxO, son « orchestrateur de diagnostic ». Sur des cas cliniques complexes tirés du New England Journal of Medicine, le système atteint 83 % de diagnostics corrects, quand des médecins généralistes plafonnent à 36 % avec accès à des ressources de référence et à 22 % sans. L’évaluation porte toutefois sur des dossiers déjà publiés, pas sur des patients, et l’entreprise reconnaît elle-même qu’une validation clinique reste à faire.
Ce que mesure l’étude
Le travail repose sur un banc d’essai construit par Microsoft, le Sequential Diagnosis Benchmark (SDBench). Son principe tranche avec les examens de type USMLE, longtemps utilisés pour évaluer les modèles en médecine : au lieu de recevoir tout le dossier d’un coup et de choisir une réponse dans une liste, le système (ou le médecin) part d’un court résumé qui ne révèle pas le diagnostic. Il doit ensuite décider, tour après tour, quelles questions poser et quels examens prescrire avant de s’engager.
Deux jeux de cas sont utilisés. Le premier rassemble 304 cas difficiles issus des conférences clinico-pathologiques publiées par le NEJM. Le second, plus proche de la pratique courante, provient de MIMIC-IV-ED, une base anonymisée de passages aux urgences du Beth Israel Deaconess Medical Center de Boston. Le score tient compte de la justesse du diagnostic, mais aussi du coût estimé des examens demandés.
Un panel de médecins virtuels
MAI-DxO n’est pas un nouveau modèle. C’est une couche d’orchestration posée sur des modèles existants, qui simule un panel de praticiens : chaque agent propose des hypothèses, sélectionne des questions ou des examens et conteste l’avis qui se dessine. Le système fait tourner ce débat sur plusieurs cycles et pèse la valeur attendue de chaque examen face à son coût. Selon le billet publié par l’équipe santé de Microsoft AI, les gains se maintiennent, et progressent, lorsque l’évaluation est refaite avec des modèles plus récents, dont GPT-5.5, sans modifier la méthode d’orchestration.
Les chiffres annoncés sont les suivants :
- sur les cas du NEJM, 83 % de diagnostics corrects pour MAI-DxO, contre 36 % pour des médecins s’aidant de manuels et d’internet et 22 % pour des médecins sans ressources, soit un rapport d’environ 2,3 et 3,7 ;
- sur les cas des urgences, 80 % pour MAI-DxO contre 47 % pour les médecins ;
- une configuration davantage optimisée sur le coût atteint 81 % sur les cas du NEJM pour moins de la moitié du coût des systèmes comparés.
Microsoft affirme qu’aucune autre approche, humaine ou automatisée, n’était à la fois plus précise et moins coûteuse sur les deux jeux de données.
Une version publiée d’un travail de 2025
Les résultats prolongent un preprint déposé en juin 2025 sur arXiv, « Sequential Diagnosis with Language Models ». MAI-DxO y était couplé au modèle o3 d’OpenAI et atteignait 80 % de bons diagnostics sur les cas du NEJM, contre une moyenne de 20 % pour les généralistes testés, avec un pic à 85,5 % dans sa configuration la plus précise. Le preprint indiquait déjà que les gains se retrouvaient avec des modèles d’OpenAI, de Google, d’Anthropic, de xAI, de DeepSeek et de Meta. La version de Science ajoute le jeu de cas des urgences, une comparaison avec des médecins disposant de ressources de référence et un passage par la relecture par les pairs.
Les limites de l’évaluation
Plusieurs éléments de la méthode encadrent la portée des chiffres. Les cas sont rétrospectifs : le système n’a examiné aucun patient. Les informations sont délivrées par un modèle « gardien » qui lit le dossier complet et, lorsque le résultat d’un examen n’y figure pas, en produit un synthétique jugé réaliste. Le diagnostic final est noté par un autre modèle, un « juge » qui attribue une note de 1 à 5 par rapport au diagnostic de référence, une note de 4 ou 5 valant réussite. Les coûts, enfin, sont estimés et non facturés.
La comparaison humaine concerne des généralistes confrontés à des cas du NEJM, choisis précisément pour leur difficulté et habituellement discutés par des spécialistes. Le format séquentiel ne reproduit pas non plus l’organisation d’un service, où un médecin peut demander un avis à un confrère. Quant à l’ouverture du banc d’essai, elle reste partielle : le code, le gardien, le juge et l’estimation des coûts sont publiés, mais le jeu de données NEJM doit être licencié auprès de la revue et les cas MIMIC exigent une accréditation sur PhysioNet.
Mustafa Suleyman, directeur général de Microsoft AI, l’a résumé auprès de The Verge : « Il faut une validation clinique. C’est un saut, mais c’est une étape majeure sur ce chemin. »
La suite annoncée
Microsoft annonce une étude prospective avec le Beth Israel Deaconess Medical Center, dans laquelle des patients interagiront directement avec le système, ses performances étant comparées aux évaluations indépendantes des médecins. Aucun calendrier ferme n’a été donné ; Dominic King, responsable santé de Microsoft AI et coauteur de l’étude, évoque auprès de The Verge un démarrage « dans les prochains mois ». Aucune date ni modalité de commercialisation n’est communiquée, et un déploiement devra passer par les exigences réglementaires propres aux dispositifs médicaux.
L’entreprise inscrit ces travaux dans un programme qu’elle nomme « superintelligence médicale », détaillé dans un article publié la même semaine dans BMJ Digital Health and AI. Il identifie d’autres capacités à atteindre au-delà du diagnostic, comme le choix des traitements ou le suivi dans la durée. Elle regroupe aussi ses équipes santé, dont Microsoft Research et les équipes des produits Dragon Copilot et PowerScribe, au sein de Microsoft AI. Une collaboration avec la Mayo Clinic doit fournir des données cliniques longitudinales.
Les prestations d’automatisation IA de DjeremIA sont décrites dans la rubrique Services.