Mistral AI a publié le 29 octobre les poids de Mistral Large 4, surnommé « Le Chonk ». Le modèle était en préversion publique depuis le début du mois. La version mise en ligne n’est pas la même : selon l’annonce de Mistral, trois semaines d’apprentissage par renforcement supplémentaires ont surtout amélioré le code agentique et la cybersécurité défensive, tout en réduisant le nombre de tokens consommés par tâche.
Un modèle de 1 000 milliards de paramètres, dont une petite partie active
Mistral Large 4 est un modèle à mélange d’experts. Le billet de Hugging Face le décrit avec environ 1 000 milliards de paramètres au total et 49 milliards actifs pour chaque token (le nom du dépôt officiel indique 52 milliards). Il accepte du texte et des images en entrée, produit du texte, et dispose d’une fenêtre de contexte d’un million de tokens. Deux formes de parcimonie se combinent : le modèle choisit un petit groupe d’experts pour chaque token, et un indexeur d’attention choisit les positions antérieures du contexte à consulter. La vision repose sur un encodeur de la famille Pixtral.
Les poids sont disponibles sur Hugging Face en FP8 et en NVFP4, avec des versions GGUF produites par Unsloth et l’équipe de llama.cpp. Le modèle est aussi servi par l’API de Mistral, par OpenRouter, par Microsoft Foundry (premier fournisseur cloud cité) et par les points d’accès de Nvidia. Mistral affiche un tarif de 0,70 dollar par million de tokens en entrée, 0,07 dollar en entrée mise en cache et 2,10 dollars en sortie.
Ce qui a changé depuis la préversion
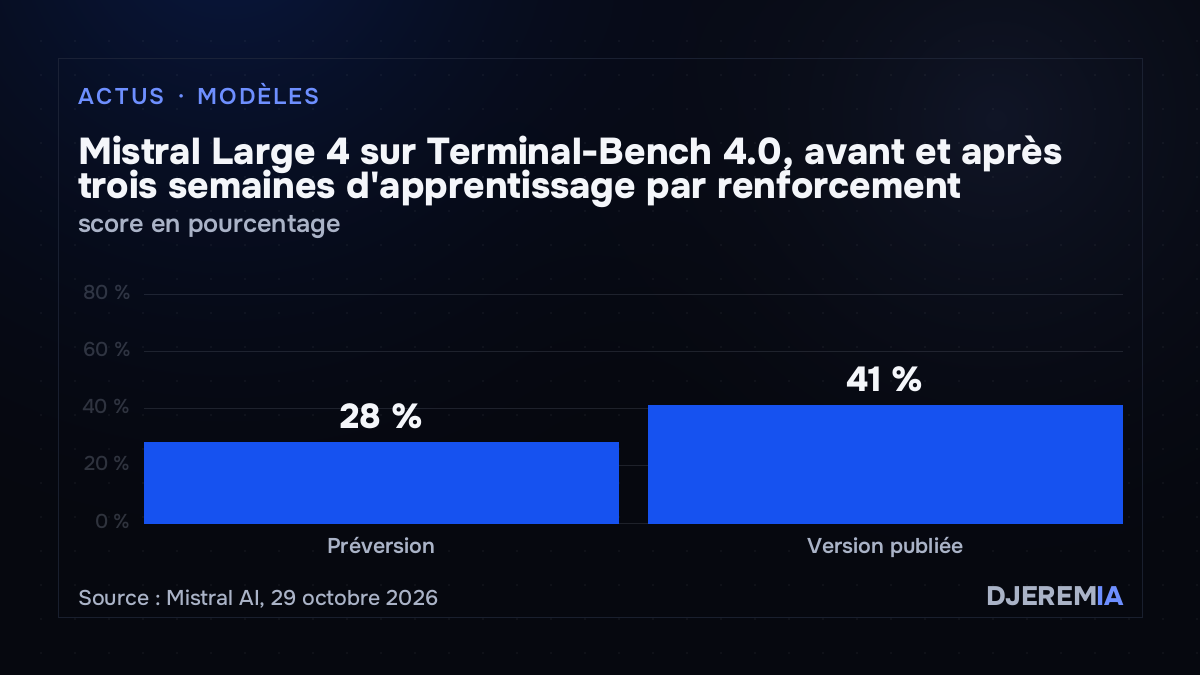
Le gain le plus net porte sur le code en terminal. Sur Terminal-Bench 4.0, Mistral annonce une hausse de 13 points, à 41 %, avec 30 % de tokens de sortie en moins par rapport à la préversion. Sur l’indice Coding Agent d’Artificial Analysis, le modèle obtient 48 %, à égalité de fait avec GLM-5.3, présenté comme le meilleur modèle ouvert, mais avec 47 % de tokens en moins par tâche en moyenne. Sur FrontierCode 2.0, un test privé de Cognition qui mesure si un mainteneur accepterait de fusionner la modification proposée, Mistral Large 4 arrive en tête avec 19,7 %.
Mistral cite aussi une évaluation humaine à l’aveugle de Surge : les correcteurs préfèrent Mistral Large 4 à GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash, et seul Claude Opus 5.5 le devance parmi les modèles comparés. Le modèle propose désormais trois modes de raisonnement, faible, moyen et élevé (par défaut), pour arbitrer entre qualité et coût.
Ces résultats viennent de l’éditeur ou de partenaires qu’il a choisis. Un rapport technique complet est annoncé « prochainement », sans date. Les chiffres du billet de Hugging Face, publié le même jour, ne coïncident d’ailleurs pas tous avec ceux de Mistral : il donne 28,3 % sur Terminal-Bench 4, soit le score de la préversion d’après le calcul de Mistral, et 49,8 % sur l’indice Coding Agent.
La cybersécurité défensive comme argument central
Mistral positionne le modèle sur la défense : reproduire une vulnérabilité, confirmer qu’elle existe puis la corriger sans casser le reste du code. Sur l’indice Cyber d’Artificial Analysis, qui mesure ces étapes, il obtient 51 % selon Mistral. Hugging Face détaille un sous-test de reproduction puis correction de failles réelles dans des logiciels libres, où il atteint 82 %, et précise que plusieurs modèles fermés y obtiennent un score proche de zéro parce qu’ils refusent la tâche.
L’argument tient au fonctionnement de ce métier : la recherche de vulnérabilités et la réponse à incident ressemblent à des attaques dans les requêtes envoyées au modèle, et les filtres des API fermées peuvent les bloquer. Avec des poids ouverts, la politique d’usage et le déploiement restent entre les mains de l’organisation qui l’exploite. Mistral affirme en parallèle un taux de refus moyen de 96,6 % sur les requêtes cyber malveillantes de JailbreakBench, StrongREJECT et AgentHarm, le plus élevé qu’il mesure parmi les modèles ouverts.
L’éditeur reconnaît lui-même une limite. Pendant la préversion, il a observé que le modèle refusait des attaques en boîte noire contre des cibles réelles, mais il écrit voir « un potentiel » d’aide à de vraies attaques et annonce modifier ses garde-fous dans les mois qui viennent. Une variante spécialisée pour les tests d’intrusion et le red teaming est réservée à des partenaires vérifiés comme Orange Cyberdefense, sous contrat et sur des systèmes autorisés. Une fois les poids téléchargés, ces corrections ultérieures ne s’appliquent toutefois qu’aux copies mises à jour par leurs utilisateurs.
Une licence ouverte, sauf pour la revente en service
Le modèle est publié sous la « Mistral Ecosystem Open-Weight License », une licence MIT modifiée. Il peut être utilisé, modifié, affiné et commercialisé librement, avec une condition : une entreprise qui propose le modèle en tant que service doit obtenir une licence commerciale distincte auprès de Mistral. La clause vise les hébergeurs qui revendraient l’accès au modèle, pas les organisations qui le déploient pour leur propre usage.
Mistral insiste enfin sur l’origine européenne du modèle, entraîné « de zéro » sur une infrastructure européenne, et cite La Banque Postale parmi les clients qui en font un critère. C’est la ligne que l’entreprise défend depuis sa levée de 3 milliards d’euros en septembre : vendre la maîtrise du modèle plutôt que le seul accès par API. La publication des poids d’un modèle de cette taille la place face aux modèles ouverts chinois, comme Kimi K3 ou GLM-5.3, qui occupaient jusqu’ici le haut des classements ouverts. Les mesures indépendantes, et le rapport technique promis, diront si l’écart annoncé se confirme hors des tests choisis par l’éditeur.
L’audit et cadrage IA de DjeremIA dispose d’une présentation distincte.