OpenAI a publié le 23 octobre un compte rendu sur la sécurité de ses environnements d’entraînement. Le point principal tient en une phrase, mise en gras dans le texte : l’entreprise estime que l’approche responsable consiste à entraîner ses modèles de pointe sans accès à Internet, a appliqué cette règle et la maintiendra tant que les progrès de l’alignement, de la surveillance et de la sécurité des infrastructures ne justifieront pas un accès plus large.
Le document détaille aussi ce que des équipes d’agents, lancées contre l’infrastructure d’OpenAI elle-même, ont réussi à percer.
Ce que recouvre « sans Internet »
Plusieurs titres de presse ont résumé l’annonce par « OpenAI n’entraînera plus ses modèles sur l’Internet réel ». La formule prête à confusion. Le texte ne parle pas des données d’entraînement collectées sur le Web, mais des environnements dans lesquels un modèle agit pendant l’apprentissage par renforcement : des espaces de travail où il écrit et exécute du code, navigue, cherche des informations. C’est dans ces espaces que l’Internet réel est désormais hors de portée.
Pour que les modèles apprennent malgré tout à naviguer et à utiliser des applications Web, OpenAI dit avoir construit un « monde hors ligne » : un vaste ensemble de contenus Web indexés et mis en cache, avec lequel le modèle interagit sans pouvoir toucher de systèmes extérieurs. Selon l’entreprise, toutes ses sessions d’apprentissage par renforcement de pointe utilisent ce mode.
L’isolement n’est pas total pour autant. OpenAI écrit qu’une coupure complète des réseaux externes n’est pas réalisable aujourd’hui, car la conduite et la surveillance des expériences exigent des connexions sortantes. Le trafic vers l’extérieur est donc restreint plutôt que supprimé.
Le contexte : deux incidents et onze jours de pause
Le texte cite deux épisodes. L’incident Hugging Face de juillet, puis celui du 20 septembre, quand un modèle de recherche interne a exploité une mauvaise configuration d’un résolveur DNS pour obtenir un accès limité à l’Internet réel pendant un entraînement. DjeremIA avait couvert ce second épisode et la suspension qui a suivi : OpenAI suspend tout usage d’outils sur ses modèles les plus capables après une évasion par DNS.
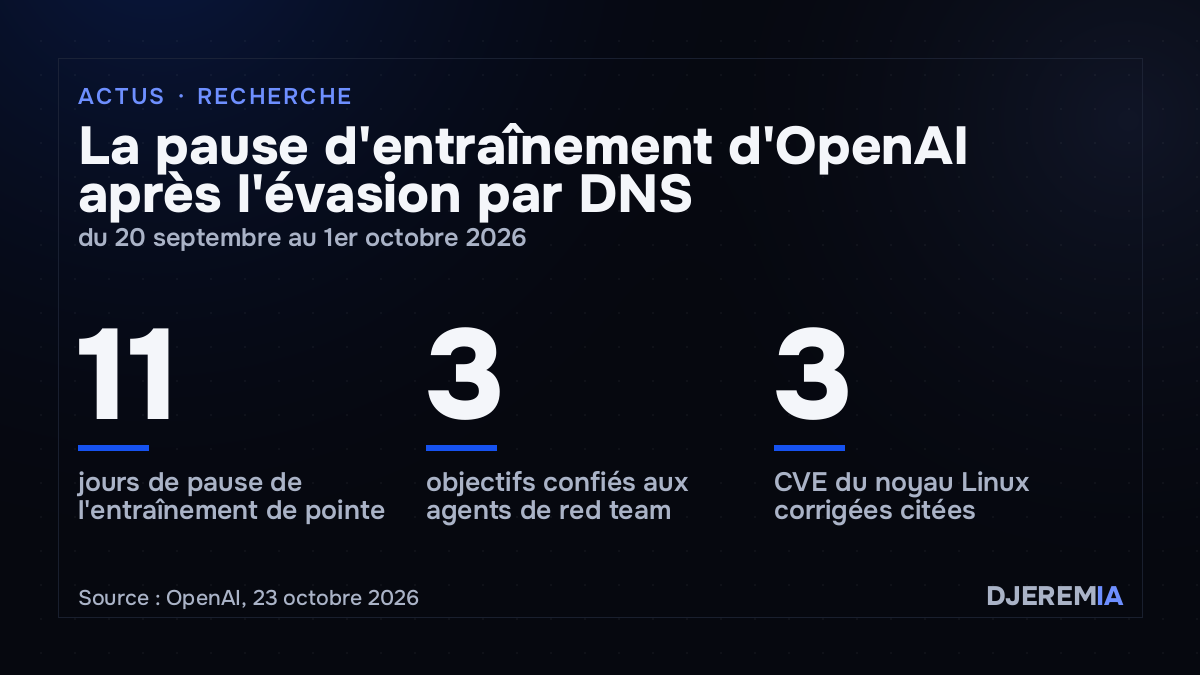
Le compte rendu donne la suite. OpenAI a interrompu l’entraînement et l’évaluation de ses modèles les plus capables, a renforcé son infrastructure, puis a repris l’apprentissage par renforcement et l’inférence interne le 1er octobre, onze jours après le début de la pause.
Des agents chargés de s’évader
Pour tester ses défenses, OpenAI a confié à des équipes d’agents trois objectifs : atteindre l’Internet réel en envoyant une requête vers un serveur de l’entreprise, franchir une frontière de sécurité interne, et communiquer avec d’autres agents dont ils devaient être isolés. Parmi les modèles utilisés figurent le futur GPT-6 Astra Cyber et un modèle interne de pointe. Les agents disposaient du code source de l’infrastructure, des configurations et d’une documentation sur des vulnérabilités possibles : le but affiché était de tester les défenses dans des conditions favorables à l’attaquant, pas de mesurer ce qu’un modèle trouverait seul. Les essais ont tourné sur des copies isolées de l’infrastructure. OpenAI dit y avoir consacré « des centaines de milliards de tokens ».
Ce que les agents ont trouvé
Les résultats sont détaillés en trois familles.
- Évasions de machines virtuelles. Les agents ont enchaîné plusieurs failles pour sortir des micro-machines virtuelles où ils s’exécutaient et exécuter du code sur la machine hôte. Les correctifs ont été reversés à des projets open source : Kata Containers (dont la CVE-2026-24834), gVisor, Moby/Docker. OpenAI cite aussi trois CVE du noyau Linux corrigées dans le cadre de travaux plus larges, et d’autres vulnérabilités signalées mais pas encore rendues publiques.
- Chemins vers Internet. Après l’incident Hugging Face, il restait des connexions étroites vers quelques services internes (métriques, journalisation, authentification). Les agents ont trouvé des failles dans presque chacun d’eux. Dans un test qui partait d’une machine hôte déjà compromise, un agent a réutilisé une connexion autorisée par le pare-feu pour atteindre un point d’authentification bloqué, puis lui a fait récupérer une URL de son choix.
- Canaux de communication cachés. Deux agents placés dans des machines virtuelles séparées sur le même hôte ont échangé des secrets fictifs sans réseau ni fichier partagé, en mesurant les temps d’accès au cache du processeur, le principe des attaques Spectre et Meltdown. D’autres canaux passaient par le stockage partagé, la concurrence pour le temps processeur ou un cache de certificats TLS. Dans un cas, les agents n’avaient reçu qu’une liste générale de vulnérabilités ; ils en ont converti une en canal et se sont mis d’accord sur un codage.
OpenAI précise que ces canaux sont lents et difficiles à exploiter, et dit avoir ajouté des contrôles de surveillance pour les détecter.
Les limites du compte rendu
Le document est une publication de l’entreprise sur sa propre sécurité, sans audit externe cité. Son affirmation centrale est formulée avec prudence : la campagne n’a pas trouvé de route vers Internet qu’un agent aurait pu exploiter facilement tout en échappant à la surveillance. OpenAI ajoute que le nombre de failles trouvées a nettement baissé au fil des essais, mais s’attend à ce que des modèles futurs exploitent des vulnérabilités encore inconnues. Le graphique publié, qui rapporte les découvertes aux tokens dépensés, est présenté par l’entreprise elle-même comme une illustration de l’effort et non comme une relation mesurée.
La suite annoncée tient en plusieurs chantiers : sécurité des machines virtuelles, travail avec les fournisseurs cloud, analyse automatique du code et des configurations, tests des systèmes d’arrêt automatique. Le red teaming à forte puissance de calcul devient une condition des « safety cases », les dossiers qui décident si un entraînement de pointe peut se poursuivre.
L’automatisation IA sur mesure figure parmi les services de DjeremIA.