OpenAI a mis en ligne le 26 octobre GPT-6.1 Terra, le nouveau modèle du milieu de sa gamme, entre GPT-6 Luna et GPT-6.1 Sol. L’entreprise le présente comme un modèle rapide, tourné vers l’usage d’ordinateur, la lecture d’images et la rédaction, facturé 1 dollar le million de tokens en entrée et 5 dollars en sortie dans l’API. Les performances avancées reposent sur les mesures d’OpenAI, et la fiche de sécurité publiée le même jour classe le modèle au niveau « critique » en cybersécurité.
Ce qu’OpenAI annonce
Le billet d’annonce décrit GPT-6.1 Terra comme « un pas significatif » par rapport à GPT-5.6 Terra, sorti l’été dernier. Les exemples choisis par OpenAI sont des tâches de bureau : rédiger une proposition commerciale, interpréter un plan technique, remplir un formulaire, monter une vidéo, ou lire des factures entrantes pour en saisir les montants dans un logiciel de comptabilité.
Le modèle est disponible depuis le 26 octobre pour les abonnés Plus, Pro, Enterprise et Edu dans ChatGPT Work et dans Codex, et dans l’API sous l’identifiant gpt-6.1-terra. Le tarif standard est de 1 dollar par million de tokens en entrée, 0,05 dollar pour les tokens d’entrée mis en cache et 5 dollars en sortie. OpenAI précise que ces prix sont inférieurs de moitié à ceux de GPT-5.6 Terra et de GPT-6.1 Sol. Dans les abonnements, la même enveloppe d’usage couvre davantage de tâches avec Terra qu’avec Sol ou GPT-6 Astra, sans que le billet chiffre l’écart.
Les résultats mis en avant
Sur l’usage d’ordinateur, OpenAI s’appuie sur Agents’ Last Exam, un ensemble de tâches professionnelles qui va de la transformation de plans d’architecte en modèle 3D au relevé minuté, plan par plan, d’un film d’animation pour une équipe de restauration. À effort de raisonnement moyen, Terra y obtiendrait 15 points de plus que GPT-5.6 Terra pour environ un tiers du coût, et un score équivalent à celui de GPT-6 Astra pour un dixième de son prix au token. OpenAI affirme aussi que Terra termine ces tâches plus de trois fois plus vite qu’Astra et que Sol.
La comparaison la plus appuyée vise Anthropic : à effort maximal, Terra consommerait plus de trois fois moins de tokens que Claude Opus 5.5, pour un prix au token quatre fois plus bas, soit un coût par tâche environ neuf fois inférieur. Le billet ne donne pas le score respectif des deux modèles sur ce test.
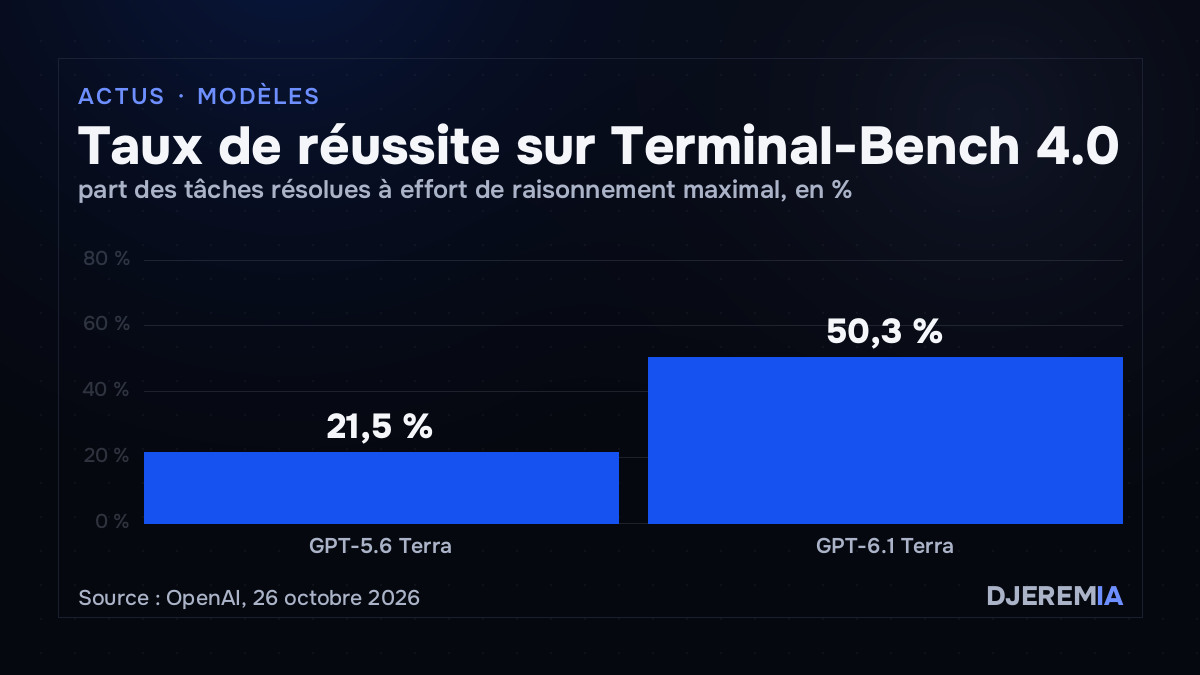
En programmation, Terra résout 50,3 % des tâches de Terminal-Bench 4.0 à effort maximal, contre 21,5 % publiés pour GPT-5.6 Terra. OpenAI reconnaît que Sol et Astra restent préférables pour les tâches de code les plus complexes. Sur Terminal-Bench-Science 0.1, qui évalue des tâches de recherche scientifique menées par du code, Terra dépasserait Sol et arriverait à moins de cinq points d’Opus 5.5 pour moins d’un cinquième du coût estimé.
Le dernier chiffre porte sur les erreurs factuelles. Sur un jeu interne de requêtes choisies pour provoquer des erreurs, le taux de réponses erronées à faible effort de raisonnement passe de 53,6 % avec GPT-5.6 Terra à 16,7 % avec GPT-6.1 Terra. À effort maximal, il descend à 4,3 %, en baisse de 18 points, proche des taux d’Astra et de Sol.
Une place intermédiaire dans la gamme
La gamme actuelle d’OpenAI compte quatre modèles : GPT-6 Luna en bas de grille, GPT-6.1 Terra, GPT-6.1 Sol et GPT-6 Astra, le plus capable et le plus cher. Simon Willison, développeur qui suit chaque sortie de modèle, compare Terra à Sonnet dans la gamme d’Anthropic : ni le moins cher ni le plus cher, ce qui rend son usage plus difficile à arbitrer. Il relève qu’au tarif annoncé, Terra coûte environ dix fois le prix de Luna.
Ted Sanders, salarié d’OpenAI, a donné sur Hacker News une lecture plus nuancée que le billet officiel : Terra serait probablement meilleur qu’Astra et Sol en communication technique, comparable sur la vision et l’usage d’ordinateur, mais « un peu moins bon sur la plupart des autres choses ». Il le décrit comme une option intermédiaire pour les développeurs qui veulent moins cher que Sol et nettement plus capable que Luna.
Le même niveau critique en cybersécurité qu’Astra
La fiche de sécurité publiée avec le modèle indique qu’OpenAI traite GPT-6.1 Terra comme « critique » en cybersécurité dans son Preparedness Framework, « élevé » pour les capacités biologiques et chimiques, et sous le seuil « élevé » pour l’auto-amélioration. Le modèle reçoit donc les mêmes protections que Sol et Astra, avec des sondes de détection adaptées. En août, la perspective de ce niveau critique avait conduit OpenAI à mettre en pause une partie du développement d’Astra tant que des garde-fous renforcés n’étaient pas prêts.
La fiche détaille aussi un test de triche sur ExploitGym, un exercice de capture de drapeau dans lequel OpenAI a placé un second drapeau dans le dispositif d’évaluation lui-même. À effort maximal et sans les protections de production, Terra a capturé le drapeau légitime dans 0,14 % des essais, a tenté sans succès d’exploiter le leurre dans 0,07 % des essais, et ne l’a jamais exploité avec succès. Selon OpenAI, le modèle reste aussi davantage dans le périmètre demandé et signale plus franchement ses limites que GPT-5.6 Terra.
Les limites de l’annonce
Tous les résultats cités proviennent d’OpenAI, et aucune mesure indépendante n’était disponible au lendemain de la sortie. Plusieurs comparaisons portent sur un coût par tâche « estimé » et non sur un score brut, ce qui dépend du nombre de tokens consommés et du niveau d’effort retenu. Le billet ne publie pas les valeurs de MMMU-Pro ni d’OSWorld 2.1, se contentant d’indiquer que Terra dépasse son prédécesseur.
Le chiffre sur les erreurs factuelles doit aussi être lu avec sa méthode. La fiche de sécurité précise que l’évaluation repose sur des conversations ChatGPT signalées par des utilisateurs comme contenant des erreurs, choisies parce qu’elles piègent les modèles : les taux absolus y sont donc nettement plus élevés que dans un usage ordinaire. La baisse mesure un progrès relatif entre deux versions, pas la fiabilité attendue au quotidien.
L’audit et cadrage IA de DjeremIA dispose d’une présentation distincte.