Samedi 24 octobre, le modérateur Wolvereness a publié sur r/opensource, l’un des principaux forums Reddit consacrés au logiciel libre, une nouvelle politique intitulée « Your tokens aren’t valuable: No more AI ». Le principe tient en une phrase : un projet qui utilise l’IA, qui a été fait par l’IA ou qui est destiné à l’IA n’y est plus le bienvenu. Dix jours plus tôt, les mainteneurs du noyau Linux prenaient la décision inverse sur un point voisin : ils ont retiré l’étiquette qui signalait les correctifs écrits avec un assistant de code, parce qu’elle ne disait plus rien de la façon dont le code est produit.
Ce que disent les nouvelles règles de r/opensource
Le message des modérateurs estime que « l’IA, telle qu’elle existe aujourd’hui, est incompatible avec cette communauté du logiciel libre ». Pour pouvoir être présenté sur le forum, un projet doit désormais réunir toutes les conditions suivantes :
- avoir au moins un an d’existence et être activement maintenu ;
- compter plusieurs contributeurs, « subjectivement 3 ou plus » ;
- ne pas être un projet d’école courant (prise de notes, lecteur PDF, lecteur de musique en ligne de commande) ;
- ne pas être destiné à l’IA, ce qui exclut par exemple les serveurs MCP ;
- disposer déjà d’une communauté et d’une licence approuvée par l’OSI.
Le compte qui publie doit avoir plus d’un an et une activité significative sur Reddit. Les projets dont l’usage de l’IA est « évident » sont refusés, avec cette justification : « Les tokens ne coûtent rien, et le nombre que vous avez dépensé pour faire votre projet ne nous intéresse pas. » Les personnes qui ne parlent pas anglais sont invitées à chercher une autre communauté, au motif que les modérateurs ne savent pas distinguer un texte écrit par une IA d’un texte traduit par une IA. Publier un contenu produit par un modèle de langage vaut un bannissement définitif. Seules les organisations à but non lucratif enregistrées peuvent obtenir une dérogation aux seuils d’âge et de contributeurs, sur demande préalable.
Le modérateur explique ce durcissement par le volume : il estime recevoir une vingtaine de messages par jour de personnes qui réclament une exception pour des projets qu’il qualifie de « slop » publiés depuis des comptes jetables.
Une communauté divisée, des forums concurrents
Selon PPC Land, le forum revendique environ 98 000 visiteurs par semaine, et l’annonce a reçu près de 1 400 commentaires en une journée pour un score de votes net nul. Une partie des réponses salue le tri des projets bâclés. D’autres pointent les effets de bord des critères qui n’ont rien à voir avec l’IA : un développeur explique dans le fil que son paquet, maintenu seul depuis neuf ans, suivi par plus de 300 étoiles sur GitHub et écrit sans IA, n’est plus admissible faute de trois contributeurs. Help Net Security rapporte qu’un autre modérateur du forum, ssddanbrown, s’est désolidarisé de la règle sur la langue, et que Wolvereness a reconnu qu’il n’existe pas de manière « objective » d’appliquer cette politique.
Des forums de repli sont apparus dans la foulée, dont r/TrueOpenSource, ouvert le 24 octobre. Le message initial a été modifié pour les saluer comme « un refuge pour ceux que cette politique touche ».
Le noyau Linux a fait le constat inverse
L’argument le plus repris contre la règle concerne les grands projets libres qui acceptent déjà du code écrit avec des assistants. Le noyau Linux en est l’exemple le plus documenté. Depuis janvier 2026, ses règles comprenaient un document de procédure dédié aux assistants de code, avec une étiquette Assisted-by à porter sur les correctifs concernés.
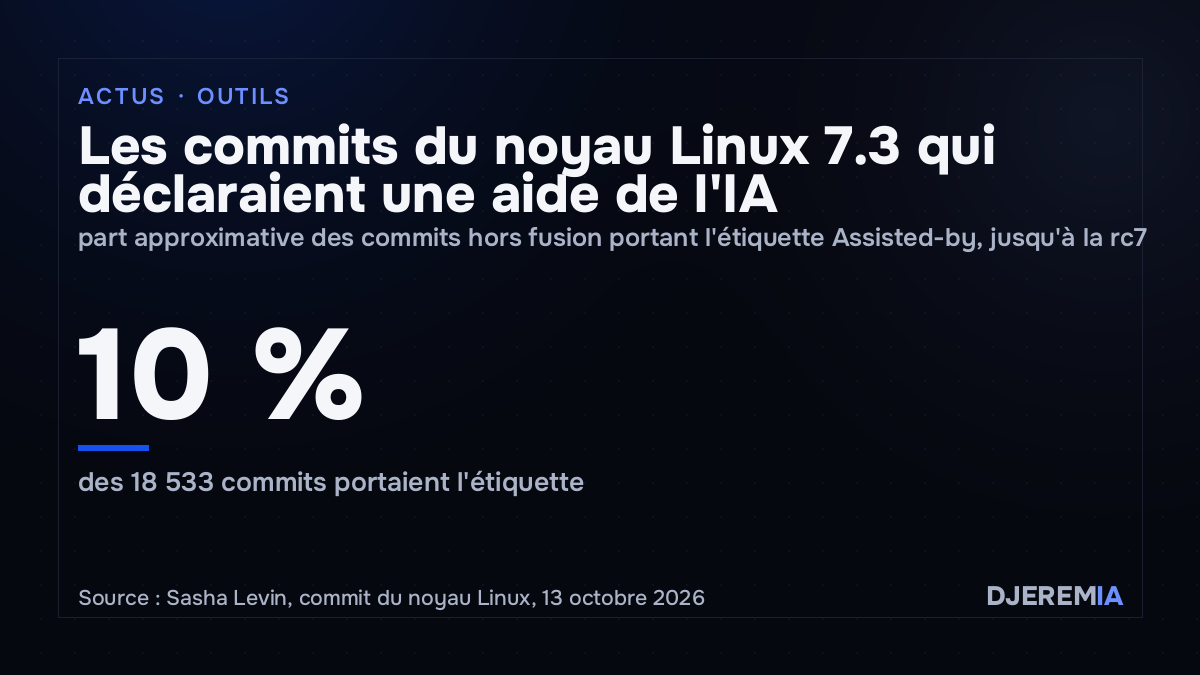
Le 13 octobre, Sasha Levin a proposé de supprimer cette étiquette, et le correctif a été accepté le 14 octobre puis intégré à la branche principale du noyau. Son message donne le chiffre qui a motivé la décision : environ 10 % des 18 533 commits hors fusion de la version 7.3, jusqu’à la rc7, portent l’étiquette, alors que l’usage réel des modèles de langage est « bien plus répandu ». Certains contributeurs ignorent la règle, d’autres l’omettent volontairement, et peu de mainteneurs la réclament. L’absence de l’étiquette ne disait donc rien sur la façon dont un correctif avait été écrit. Greg Kroah-Hartman, qui avait défendu son maintien en juillet, a soutenu le retrait.
Le noyau n’a pas pour autant renoncé à la transparence. Le document sur le contenu généré par des outils reste en vigueur : il demande de décrire dans la lettre d’accompagnement les outils utilisés, et les prompts lorsque le code vient d’un échange court. Un agent ne peut toujours pas apposer de Signed-off-by : seul un humain peut certifier l’origine du code et en assume la responsabilité.
Linus Torvalds a lui-même publié début octobre une série de correctifs expérimentaux sur la lecture du cache de pages, en précisant, selon Linuxiac, que le code, les programmes de test et le premier jet de la description avaient été produits avec Claude Code « sous [sa] direction ». La série n’est pas fusionnée, et des relecteurs y ont relevé une situation de compétition.
Deux réponses à un même problème de relecture
Les deux décisions partent d’une contrainte commune : le temps des personnes qui trient et relisent est limité, et les outils génératifs augmentent le volume de ce qui leur arrive. Le noyau traite la question au niveau de chaque contribution, en conservant la responsabilité humaine et une obligation de transparence, après avoir constaté qu’un marquage déclaratif n’était pas respecté. r/opensource la traite au niveau du projet entier, par des critères d’exclusion que ses propres modérateurs reconnaissent difficiles à appliquer de façon objective, et qui écartent aussi des projets anciens maintenus par une seule personne.
La définition du logiciel libre, elle, ne dit rien de la manière dont le code est écrit : elle porte sur les licences et les libertés accordées aux utilisateurs. La règle de r/opensource relève donc d’un choix de modération propre à ce forum, et non d’une position du mouvement open source, dont plusieurs projets majeurs, Linux en tête, encadrent l’usage de ces outils plutôt que de l’interdire.
Les formations sur l’IA de DjeremIA sont présentées dans une rubrique distincte.