OpenAI, Google, Microsoft et Anthropic ont annoncé le 30 octobre qu’ils liront une même règle de robots.txt, User-Agent: __usage_ai-training, pour savoir si un site refuse que ses pages servent à entraîner des modèles génératifs. Le mécanisme sort d’un brouillon déposé le même jour à l’IETF par Kevin Kelley, responsable des standards chez Anthropic. Aucun des quatre ne l’applique encore : Google et Microsoft visent le début de 2027, OpenAI « les prochains mois ».
Aujourd’hui, un éditeur qui veut écarter ses contenus de l’entraînement doit nommer chaque robot un par un : GPTBot pour OpenAI, Google-Extended pour Google, ClaudeBot pour Anthropic, CCBot pour Common Crawl, et ainsi de suite à chaque nouvel acteur. Le signal commun remplace cette liste par une seule déclaration, lue par tous les fournisseurs qui choisissent de l’honorer.
Ce que contient le brouillon de l’IETF
Le texte, draft-kelley-aipref-training-preference-signal-00, est daté du 30 octobre 2026 et vise le statut de norme. Son choix central est de ne rien ajouter à la grammaire de robots.txt définie par la RFC 9309. Le signal prend la forme d’un groupe ordinaire, dont la ligne User-Agent ne désigne pas un robot mais un usage, ce que le brouillon appelle un « jeton de politique » (policy token).
L’exemple du brouillon tient en trois lignes : User-Agent: __usage_ai-training, puis Disallow: / et Allow: /press-kit/. Il exprime un refus de l’entraînement pour tout le site, sauf le dossier presse, pour lequel il exprime un accord. Les chemins suivent les règles habituelles de correspondance la plus longue.
Quatre précisions du texte encadrent sa portée :
- Un groupe
User-Agent: *ne vaut jamais préférence. Un robots.txt qui ne contient pas le jeton n’exprime donc aucun choix, ce qui est le cas de tous les fichiers publiés à ce jour, comme le rappelle Kevin Kelley dans son message à la liste du groupe de travail. - Le jeton porte sur l’usage, pas sur l’exploration. Les règles adressées à chaque robot continuent de gouverner ce qu’il a le droit de télécharger.
- La définition de l’entraînement est celle du vocabulaire AIPREF (version 08 du 13 septembre 2026) : modifier les paramètres d’un modèle génératif. Les modèles de classement ou de notation n’entrent pas dans le périmètre.
- Les préférences qui s’appliquent à un contenu sont celles du robots.txt en vigueur au moment où il a été récupéré. Le signal ne remonte pas dans le temps, et un accord privé entre un éditeur et un fournisseur peut passer outre.
Quatre annonces, quatre calendriers
Les engagements ont été publiés séparément le même jour. Ils ne disent pas tous la même chose.
| Acteur | Échéance annoncée | Précision propre |
|---|---|---|
| OpenAI | « dans les prochains mois » | Les contrôles existants par robot restent appliqués. |
| 2027, début d’année selon sa page des robots | Un refus via le jeton vaut refus de Google-Extended, sauf si Google-Extended est nommé explicitement. | |
| Microsoft | 1er février 2027, réglages à faire avant le 1er mars 2027 | Ajoute une préférence page par page et une préférence distincte pour l’ancrage des réponses (grounding). |
| Anthropic | non précisée | Auteur du brouillon, déposé comme contribution au groupe de travail. |
Google est le seul à décrire la règle de priorité entre l’ancien et le nouveau dispositif. John Mueller l’écrit ainsi sur le blog Search Central :
« Lorsqu’un site utilise ce jeton pour refuser l’entraînement dans son fichier robots.txt (et que Google-Extended n’est pas spécifié explicitement), Google prévoit de l’interpréter comme si l’éditeur avait interdit Google-Extended. »
Microsoft va plus loin dans le détail. À partir du 1er février 2027, Bing cessera de lire les balises NoArchive et NoCache comme des préférences d’entraînement ou d’ancrage dès qu’il détecte les nouvelles. L’ancrage, c’est-à-dire l’usage d’une page pour nourrir une réponse générée dans Copilot ou dans les résumés de recherche, reçoit sa propre balise avec trois valeurs, dont DisallowExtended, qui limite l’usage aux produits opérés par Microsoft et l’exclut des services revendus à des tiers. Microsoft avertit que refuser l’ancrage réduira la visibilité dans les réponses générées, sans toucher au classement dans Bing.
Le relevé : douze médias français, de 9 à 22 robots IA nommés
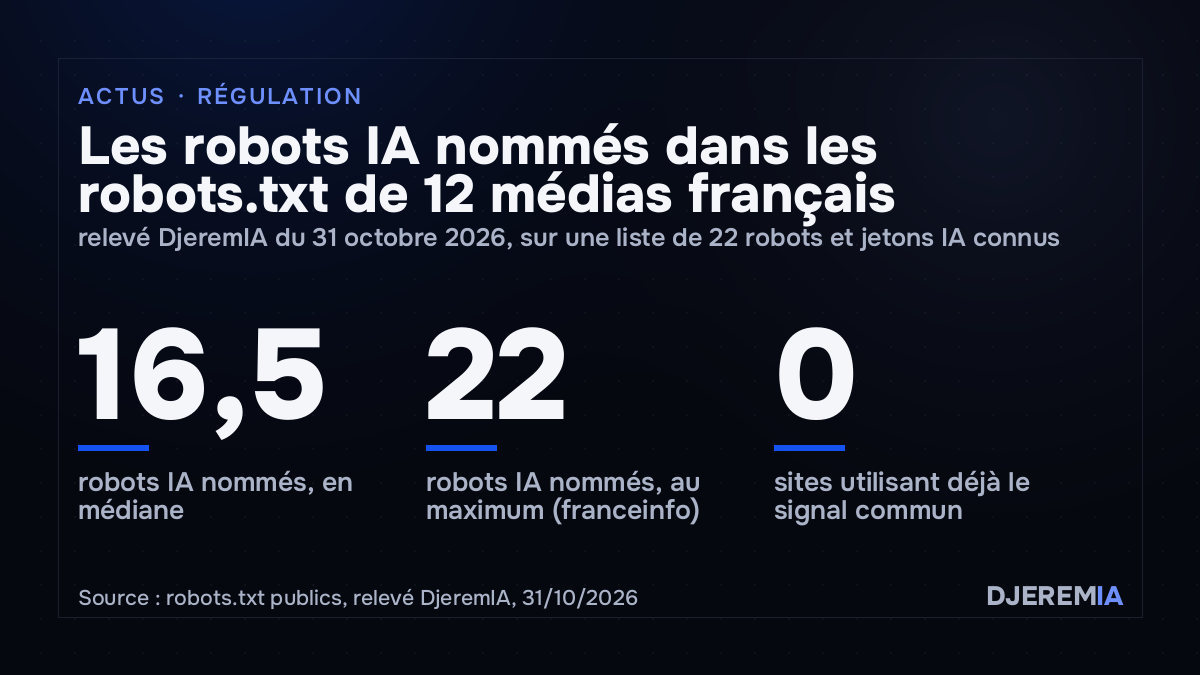
Pour mesurer la charge que le jeton doit alléger, DjeremIA a relevé le 31 octobre 2026 les robots.txt de douze sites d’information français, en comptant les lignes User-Agent qui nomment l’un des 22 robots ou jetons IA les plus répandus. Le décompte ne dit pas si chaque robot est bloqué ou autorisé, seulement s’il est cité.
| Site | Robots IA nommés | Jeton commun |
|---|---|---|
| franceinfo.fr | 22 | non |
| ouest-france.fr | 20 | non |
| lesechos.fr | 20 | non |
| bfmtv.com | 20 | non |
| liberation.fr | 17 | non |
| lexpress.fr | 17 | non |
| lemonde.fr | 16 | non |
| lefigaro.fr | 14 | non |
| nouvelobs.com | 14 | non |
| 20minutes.fr | 12 | non |
| leparisien.fr | 11 | non |
| mediapart.fr | 9 | non |
La médiane s’établit à 16,5 robots nommés. Les listes ne se recoupent pas : Le Monde ne cite pas GPTBot, Mediapart ne cite pas ChatGPT-User, Le Parisien ne cite pas Google-Extended. Une partie de ces noms désigne d’ailleurs des robots de recherche ou d’agents (OAI-SearchBot, ChatGPT-User, PerplexityBot) que le jeton commun ne couvre pas, puisqu’il ne porte que sur l’entraînement. Le signal simplifiera donc la partie entraînement de ces fichiers sans supprimer les règles par robot.
Ce que l’annonce ne règle pas
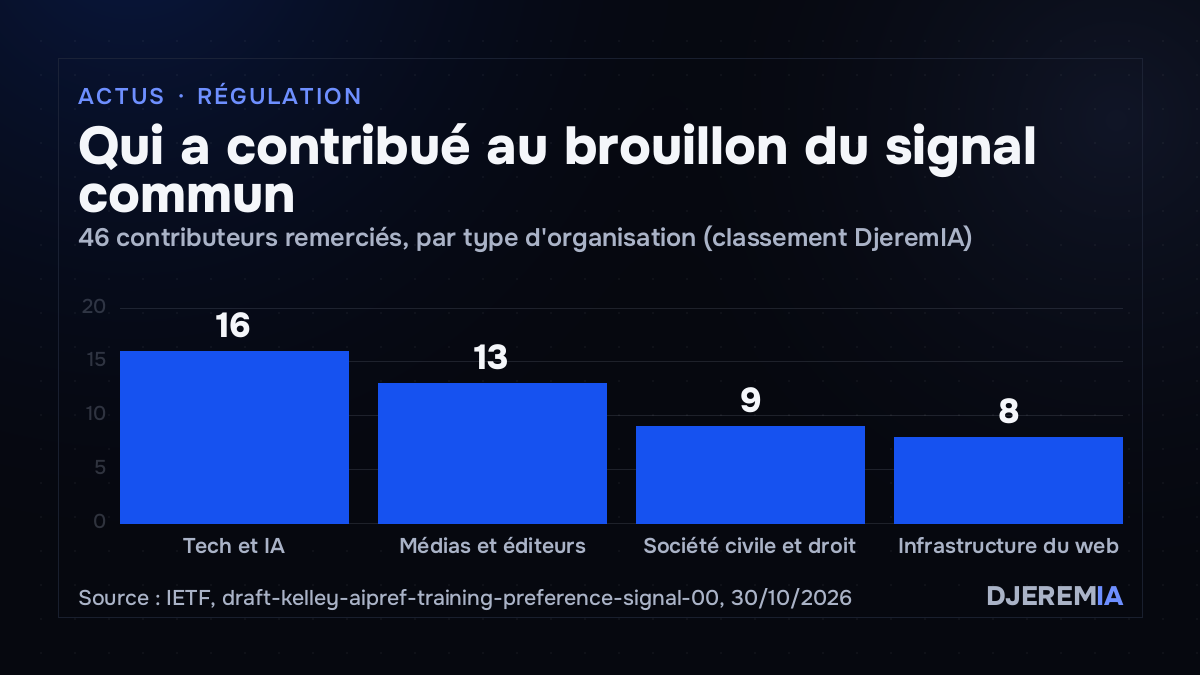
Le dispositif reste volontaire. Il engage les fournisseurs qui l’ont annoncé, pas les robots qui ignorent déjà robots.txt. Le brouillon remercie 46 contributeurs issus de 35 organisations, dont Meta, Amazon Web Services, Cloudflare et Common Crawl, mais aucun de ces quatre n’a publié d’engagement de mise en œuvre à ce stade. Les éditeurs y sont représentés (News Corp, Financial Times, BBC, Bertelsmann, Elsevier, le European Publishers Council), au côté d’associations comme l’Electronic Frontier Foundation et Creative Commons.
Le texte est aussi un brouillon individuel de version 00, qui expire le 3 mai 2027 s’il n’est pas repris. Kevin Kelley le présente comme une contribution aux travaux du groupe sur l’attachement des préférences, pas comme un texte adopté. Google rattache enfin son engagement au code de bonnes pratiques de l’AI Act européen pour les modèles d’usage général, qui reconnaît robots.txt comme moyen principal d’exprimer une réserve lisible par machine. C’est sur ce terrain réglementaire, plus que sur le vocabulaire technique, que le texte devrait être discuté dans les prochains mois.
Les formations sur l’IA de DjeremIA sont présentées dans une rubrique distincte.