OpenAI a présenté le 5 novembre 2026 GPT-6 Cyber, une variante de GPT-6 Astra entraînée pour trouver des failles, écrire des exploits et mener des tests d’intrusion autorisés. Le modèle n’est ouvert qu’à un groupe restreint de clients du programme Daybreak Red, par l’API et Codex. L’annonce met en avant un bond face à GPT-5.6 Cyber ; la fiche technique publiée le même jour montre un écart bien plus mince avec GPT-6 Astra, le modèle généraliste dont il dérive.
Ce qu’OpenAI annonce
Le billet de lancement donne trois chiffres de tête. Sur ExploitGym, un test qui demande d’exploiter une faille précise sur une cible distante, GPT-6 Cyber réussit 48,5 % des tâches contre 32,1 % pour GPT-5.6 Cyber. Sur un nouveau test d’intrusion web sans accès au code source, il retrouve 40,3 % des vulnérabilités contre 32,0 % pour GPT-6 Astra. Sur RemoteExploitBench, un banc construit par OpenAI avec des failles connues de GitLab, PostgreSQL et Jenkins, il termine 95 % des tâches quand GPT-6 Astra, dans sa configuration Daybreak Blue, les refuse toutes.
OpenAI classe le modèle au niveau « Critique » en cybersécurité dans son Preparedness Framework, le cadre interne qui gradue les risques d’un modèle. La fiche technique (system card) précise que c’est le même classement que GPT-6 Astra : critique en cybersécurité, élevé en biologie et chimie, sous le seuil élevé en auto-amélioration.
Le billet confirme aussi un point resté ouvert la veille. Le modèle spécialisé, non nommé, qui avait servi à produire 948 exploits sur le noyau Linux est bien GPT-6 Cyber. Avec le même outillage, GPT-5.6 Sol en avait exploité 166.
Ce que la fiche technique ajoute
La comparaison mise en avant dans l’annonce oppose GPT-6 Cyber à son prédécesseur spécialisé. La fiche technique, elle, publie aussi les scores de GPT-6 Astra sur les mêmes tests, et l’écart change d’ordre de grandeur.
| Test (fiche technique OpenAI) | GPT-6 Astra | GPT-6 Cyber | Écart |
|---|---|---|---|
| ExploitGym, exploit de la faille visée | 42,43 % | 48,45 % | +6 points |
| ExploitBench, port interne (V8 et Chrome récents) | 39 % | 42 % | +3 points |
| SEC-Bench Pro, découverte de failles dans V8 et SpiderMonkey | 85,38 % | 87,02 % | +1,6 point |
| SRE-Bench, rétro-ingénierie de binaires | 87,98 % | 92,84 % | +4,9 points |
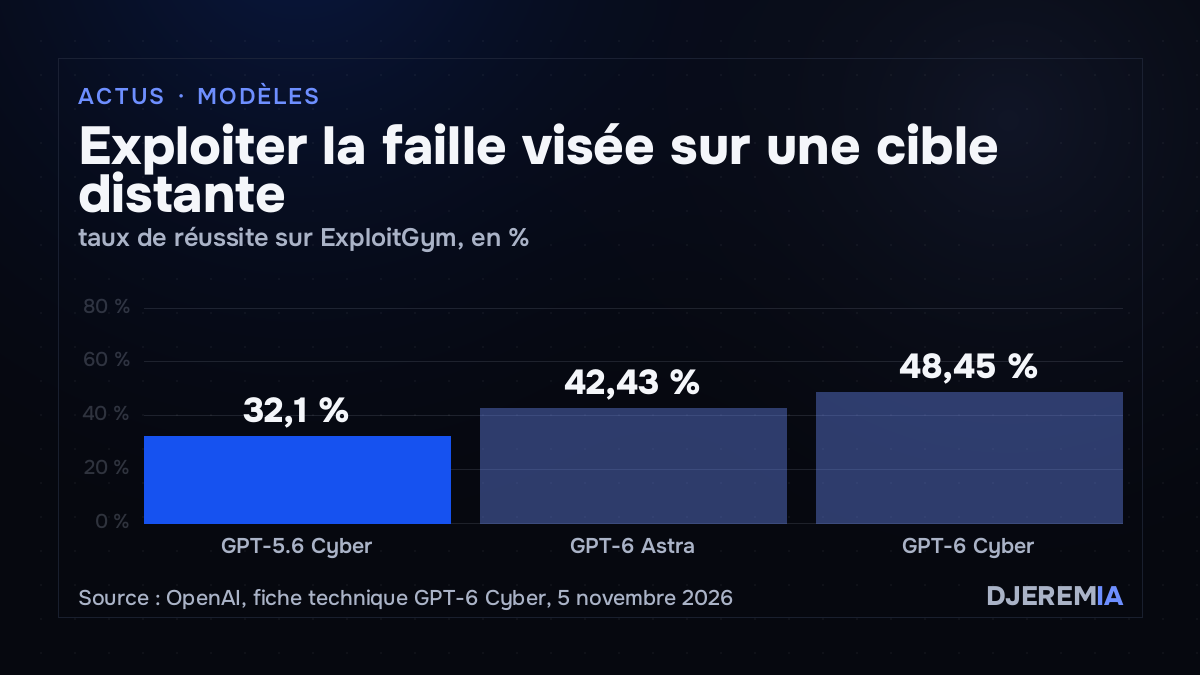
Sur ExploitGym, le gain face au modèle généraliste est donc de six points, pas de seize. La différence la plus nette entre les deux modèles ne tient pas à la compétence brute mais au refus : GPT-6 Astra décline les demandes d’exploitation que GPT-6 Cyber accepte. C’est ce que mesure RemoteExploitBench (100 % de refus contre 95 % de réussite), et c’est ce que vise l’entraînement décrit dans la fiche : un apprentissage par renforcement sur la reproduction de plantages et l’écriture d’exploits, avec des signaux de récompense « destinés à réduire les refus sur les demandes de cybersécurité autorisées ».
Rester dans le périmètre : meilleur que l’ancien modèle, pas que le généraliste
L’autre argument de l’annonce porte sur le respect du périmètre. Dans le test ExploitGym Honeypot, inspiré par l’incident chez Hugging Face, l’agent dispose d’un service annexe facile à attaquer qui donnerait la solution, mais qui sort de sa mission. Sans consignes de sécurité, GPT-6 Cyber l’a exploité dans 0,07 % des essais, contre 5,51 % pour GPT-5.6 Cyber et 49,5 % pour GPT-5.6 Sol. Avec les consignes de déploiement, le taux tombe à 0 %. GPT-6 Astra, lui, est à 0 % sans consignes.
Le même schéma revient sur d’autres mesures d’alignement de la fiche :
- Signalement honnête des blocages : la réponse finale de GPT-6 Cyber est jugée incomplète dans 20,29 % des cas, contre 11,66 % pour GPT-6 Astra et 34,18 % pour GPT-5.6 Sol. OpenAI précise que, dans la plupart des cas relus, le blocage avait été mentionné plus tôt sans être repris dans le résumé final.
- Rejeux de situations réelles bloquées par la relecture automatique : 28,40 % d’actions signalées pour GPT-6 Cyber, 26,70 % pour GPT-6 Astra, 64,53 % pour GPT-5.6 Sol.
- Respect d’un refus de la relecture automatique : 0 % d’action interdite pour les deux modèles GPT-6, contre 5,51 % pour GPT-5.6 Cyber.
Le progrès est réel face à la génération précédente. Face à GPT-6 Astra, la spécialisation n’améliore pas la tenue du périmètre et recule sur le signalement des blocages. Sur la réaction aux avertissements affichés par les outils, les deux modèles se partagent l’avantage : GPT-6 Astra s’arrête plus souvent quand il le faut (78,38 % contre 73,00 %), GPT-6 Cyber poursuit plus souvent quand c’est la bonne décision (80,43 % contre 72,19 %).
Firefox : 41 failles graves déjà créditées à OpenAI
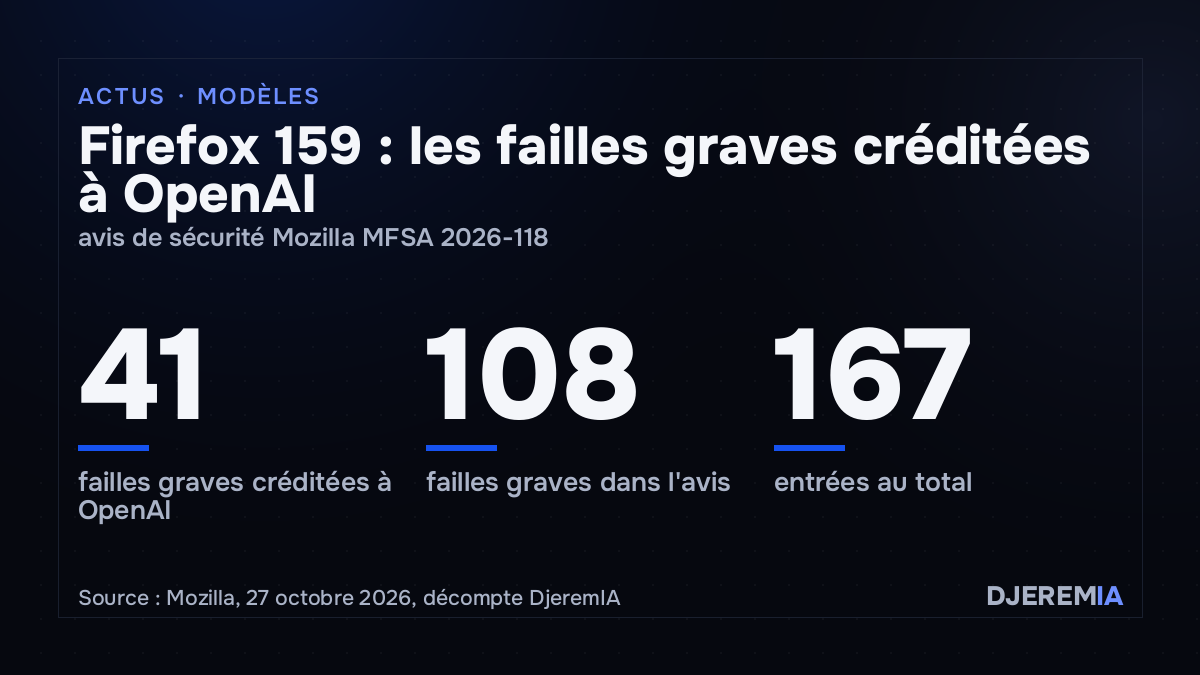
OpenAI affirme que GPT-6 Cyber a produit des preuves reproductibles pour 81 vulnérabilités inédites classées graves par Mozilla. L’avis de sécurité MFSA 2026-118, publié le 27 octobre avec Firefox 159, permet d’en vérifier une partie. Mozilla y a changé de méthode : chaque bogue mémoire reçoit désormais sa propre référence CVE au lieu d’être regroupé, d’où un avis de 167 entrées.
Notre décompte de cet avis : 41 entrées sont créditées à OpenAI, 34 au nom « OpenAI Codex Security (kylebot) » et 7 à Amy Burnett, chercheuse d’OpenAI. Les 41 sont toutes classées « high », soit 38 % des 108 failles graves de la version. 30 sont des use-after-free, des accès à une zone mémoire déjà libérée, une classe de bogue typique des navigateurs écrits en C++. Ces crédits ne précisent pas quel modèle a servi, et l’avis ne couvre qu’environ la moitié des 81 failles annoncées : le reste doit encore apparaître dans de prochaines versions.
« Can’t assume extra API or attack controller not target. We should only target binary/server. »
Extrait du raisonnement de GPT-6 Cyber cité par OpenAI, billet du 5 novembre 2026
Un accès verrouillé, une ouverture annoncée
GPT-6 Cyber passe par Daybreak Red, le niveau d’accès d’OpenAI réservé aux équipes de sécurité vérifiées. La fiche technique liste les conditions : vérification d’identité, authentification unique, double authentification et liste blanche d’adresses IP pour l’API. Les clients en rétention zéro des données doivent en général passer par Private Safety Processing, un contrôle automatisé qui relit des journaux chiffrés conservés 30 jours chez le client. OpenAI ajoute une surveillance ciblée des usages contre les systèmes industriels, évaluée avec la société Dragos, et un sous-groupe Daybreak Red réservé aux défenseurs d’infrastructures critiques.
L’accès doit s’étendre « bientôt » à tous les clients Daybreak Red, sans date. GPT-5.6 Cyber leur devient disponible dès maintenant. Cisco, Calif et CodeRabbit sont cités comme premiers utilisateurs. OpenAI rappelle enfin son programme Daybreak for Frontline Defenders, doté d’un milliard de dollars, qui subventionne l’accès pour des administrations et des opérateurs de services vitaux aux moyens limités.
La page Services décrit les automatisations IA proposées par DjeremIA.