Snowflake a publié le 27 octobre SnowPR, un banc d’essai d’agents de programmation construit à partir de son propre code. Les 65 tâches sont de vraies pull requests fusionnées par ses ingénieurs, notées par les tests cachés qui les accompagnaient. Résultat principal : avec le même modèle, Opus 5, quatre agents différents obtiennent des taux de réussite indiscernables, mais leur coût par essai varie de près d’un tiers.
Pourquoi une entreprise construit son propre banc d’essai
Le point de départ est un constat sur les benchmarks publics. SWE-bench, la référence du secteur, puise ses tâches dans une douzaine de projets Python d’environ 3 000 fichiers chacun, et Snowflake note que les modèles sont de plus en plus réglés pour y obtenir de bons scores. Son monorepo, lui, compte 63 000 fichiers source hors tests et 17 millions de lignes de code hors tests (43 millions au total), surtout en Java et en C++, compilés dans un seul graphe Bazel.
D’après le billet, ce dépôt contient 21 fois plus de fichiers et 39 fois plus de lignes que la moyenne des dépôts de SWE-bench. Le correctif de référence d’une tâche SnowPR modifie en moyenne 4 fichiers et 262 lignes, contre 1,7 fichier et 33 lignes dans SWE-bench. Dans 39 tâches, les tests notés démarrent leur propre instance de FoundationDB, la base qui stocke les métadonnées de Snowflake. Et comme tout le code est privé, aucune tâche ne figure dans les données d’entraînement publiques.
Comment les tâches ont été choisies
Lors de la plus grande passe de sélection, des règles simples ont réduit 13 965 changements fusionnés en un mois à 4 218 candidats. Un modèle à poids ouverts, hébergé sur les GPU de l’entreprise, les a ensuite classés selon leur difficulté et la possibilité de les noter. Des agents IA ont inspecté 384 des candidats les mieux classés, 84 ont été retenus, puis des ingénieurs ont relu chaque tâche construite.
Le modèle sert de filtre, jamais de juge : Snowflake indique que les taux de réussite prédits par un juge automatique suivaient à peine les taux mesurés (corrélation de Spearman de 0,18 sur 51 tâches). Chaque tâche doit passer avec le vrai correctif, échouer avec un changement vide, réussir onze contrôles automatiques et une relecture adversariale, qui a relevé 84 problèmes sur 49 tâches avant publication, dont huit bloquants.
Un détail du protocole mesure à quel point la consigne pèse sur le résultat. Avec les mêmes tests cachés et le même correctif, dix agents ont réussi 83 % des essais sur la description d’une pull request rédigée par un ingénieur, et 57 % sur celle rédigée par un autre.
Même modèle, même score, coûts différents
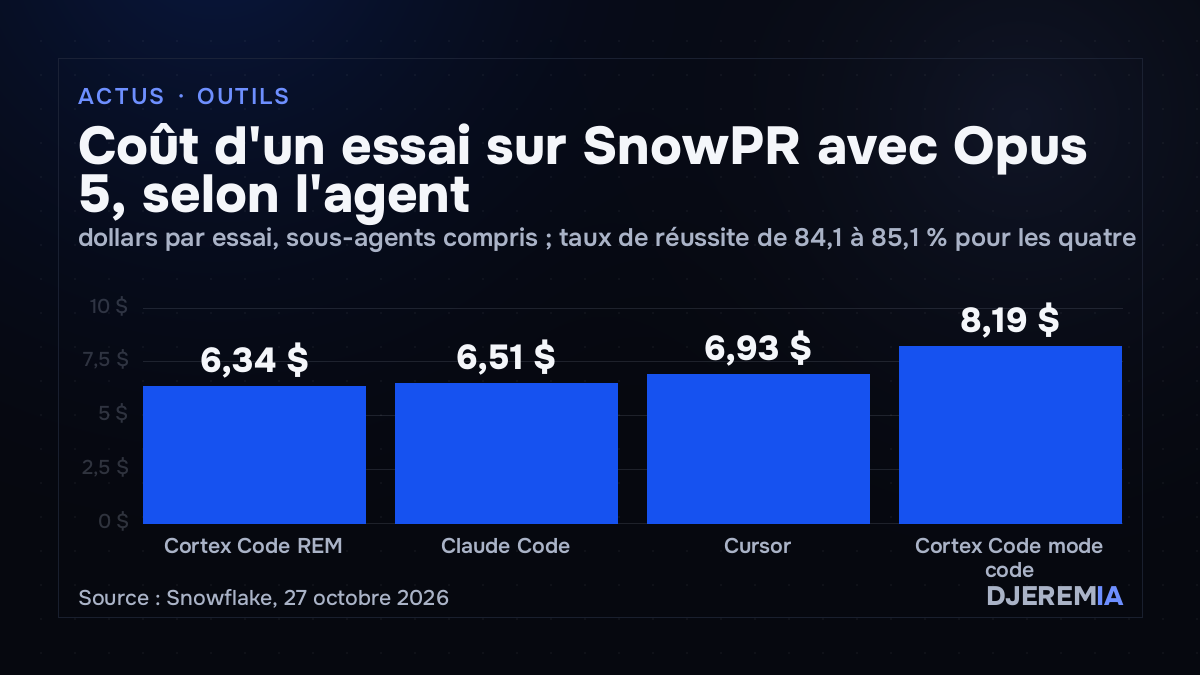
Snowflake a fait tourner sept agents, chacun associant un harnais et un modèle, trois fois sur chacune des 65 tâches. Avec Opus 5, les quatre harnais testés (Cortex Code en mode REM, Claude Code, Cursor et Cortex Code en mode code) réussissent entre 84,1 % et 85,1 % des essais. L’entreprise précise qu’un tel écart est trop faible pour être détecté sur 65 tâches.
Le coût par essai, sous-agents compris, sépare en revanche les outils : 6,34 dollars pour le mode REM, 6,51 pour Claude Code, 6,93 pour Cursor et 8,19 pour le mode code. Le mode REM, une variante interne de Cortex Code qui expose les opérations de fichier, de shell et de SQL comme des fonctions Python dans un seul outil REPL, a coûté 23 % de moins que le mode code et consommé 14 % de tokens nouveaux en moins, au prix d’une exécution plus longue. Il a aussi résolu au moins une fois 62 des 65 tâches, le meilleur total. Ce mode n’est pas encore ouvert aux clients.
Le modèle plus léger, Haiku 5.5, donne une hiérarchie comparable : 70,8 % de réussite pour 0,24 dollar par essai en mode REM, contre 64,1 % pour 0,26 dollar dans Claude Code. Codex, l’agent d’OpenAI, atteint 74,4 %, un écart que Snowflake juge là encore non détectable, pour un coût près de neuf fois supérieur. Le modèle reste le facteur dominant : chaque agent sous Opus 5 réussit de 10 à 21 points de plus que chaque agent sous Haiku 5.5. Ce constat rejoint la discussion récente sur la conception des harnais, après les recommandations d’Anthropic sur les sous-agents.
Ce qui rend une tâche difficile
Les propriétés propres au monorepo sont celles qui prédisent l’échec. En moyenne sur les sept agents, les deux tâches qui modifient à la fois du Java et du C++ passent 55 % des essais. Les tâches qui touchent trois fichiers source ou plus passent 70 % des essais, contre 89 % pour une ou deux. Celles qui s’appuient sur FoundationDB passent 75 %, contre 83 % sans, et représentent huit des dix tâches réussies moins d’une fois sur deux.
Deux résultats ont surpris l’équipe. Le C++ seul n’est guère plus difficile que le Java seul (76 % contre 80 %) : c’est le franchissement de la frontière entre les deux langages qui pose problème. Et les 43 tâches étiquetées « difficiles » lors de leur construction restent réussies dans 74 % des essais.
Les limites revendiquées
Snowflake présente SnowPR comme un classement fiable au niveau des catégories de modèles, pas entre agents proches. Avec environ 200 tâches, l’entreprise estime qu’elle pourrait détecter un écart de sept points, contre douze aujourd’hui. Le banc d’essai ne couvre que les corrections vérifiables par des tests : la qualité de conception, la refactorisation, l’écriture de tests et les réponses aux questions sur le code n’y sont pas mesurées. Les tests de bout en bout de son système Snowfort, qui couvrent environ un quart des pull requests livrées avec un test, ne peuvent pas encore tourner dans un conteneur de tâche.
Il faut aussi rappeler que Snowflake commercialise son propre agent, Cortex Code, et que SnowPR lui sert explicitement de banc de test interne. Le mode REM, arrivé en tête sur le coût, est le sien. Les données et les tâches ne sont pas publiques, ce qui empêche toute reproduction extérieure. L’entreprise prévoit d’ajouter des modèles ouverts servis sur ses propres GPU et des juges LLM calibrés sur des exemples relus par des humains.
Les prestations d’automatisation IA de DjeremIA sont décrites dans la rubrique Services.