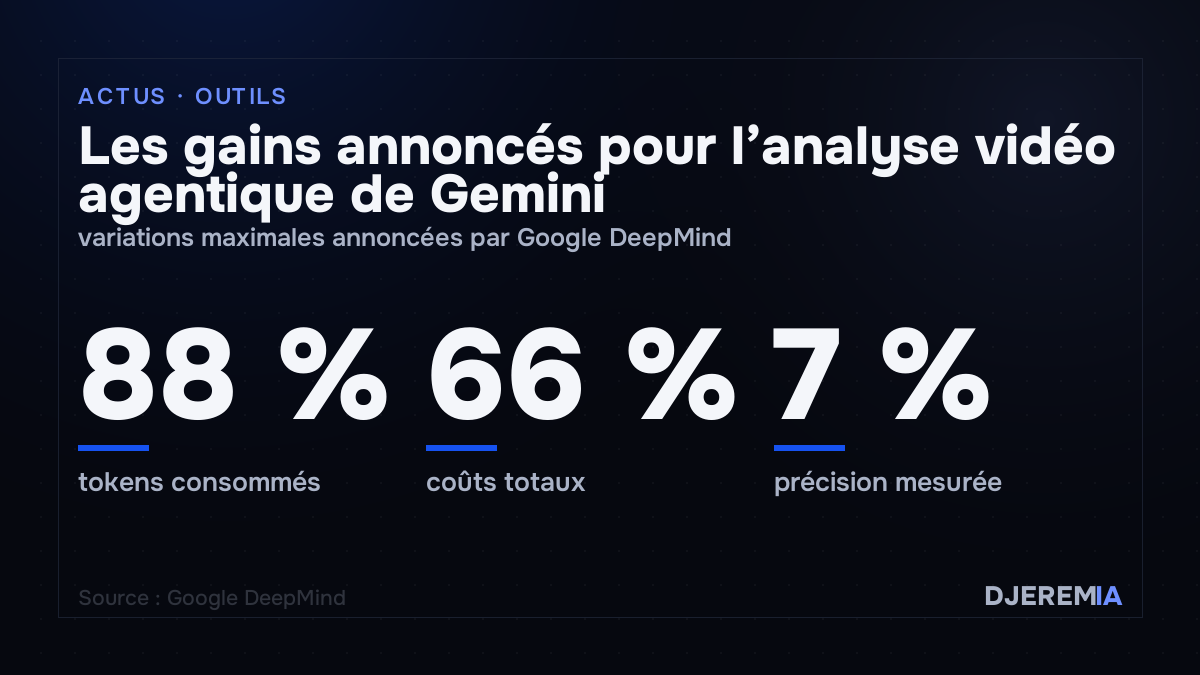
Google DeepMind vient de rendre disponible dans l’API Gemini une fonctionnalité qui réduit la consommation de tokens pour l’analyse vidéo de 88 % et les coûts de 66 %. Pas une beta fermée, pas un futur lointain : tu actives un paramètre dans ta config API aujourd’hui, sans surcoût.
Ce que tu faisais avant et pourquoi c’était cher
Jusqu’ici, analyser une vidéo avec un LLM revenait à envoyer l’intégralité du fichier. Le modèle ingérait à raison d’une image par seconde par défaut, et facturait chaque frame. Une heure de conférence à 1 FPS représente 3 600 images, soit des millions de tokens. Pour chercher un passage de 10 secondes dans un enregistrement de deux heures, tu payais pour la totalité.
L’agentic video understanding renverse ça. Au lieu d’ingérer à taux fixe, le modèle décide lui-même ce qu’il regarde, à quelle vitesse et via quel canal (images, audio, transcription). Il parcourt d’abord la vidéo en diagonale, identifie les segments pertinents et ne charge en haute résolution que ce dont il a besoin. Google appelle ça une « boucle agentique interne » : le modèle invoque un outil natif pour charger les segments à la demande.
Les chiffres et ce qu’ils signifient
Mesurés sur les benchmarks standard de compréhension vidéo longue durée (LongVideoBench), les gains sont :
- Jusqu’à -88 % de tokens consommés
- Jusqu’à -66 % de coûts
- Jusqu’à +7 % de précision
Ces gains sont particulièrement marqués sur les vidéos longues, là où le traitement statique oblige à choisir entre brûler des tokens ou rater des détails critiques. Gemini 3.7 Flash avec l’agentic understanding est présenté comme le meilleur équilibre qualité/coût sur ces benchmarks, selon Google DeepMind.
Le modèle fait maintenant ce qu’un humain ferait naturellement face à une vidéo : parcourir en diagonale, s’arrêter sur ce qui compte, revenir sur un passage ambigu. C’est la différence entre relire 400 pages mot à mot ou savoir où regarder.
Comment l’activer : une ligne dans ta config
La fonctionnalité est disponible dès maintenant sur Gemini 3.7 Flash, 3.6 Flash et 3.5 Flash-Lite, via l’API dans Google AI Studio et la Gemini Enterprise Agent Platform. Pour l’activer :
interaction = client.interactions.create(
    video={"uri": "https://youtu.be/TON_ID_VIDEO"},
    text="Quels sont les 3 points principaux de ce webinaire ?",
    config={"processing": "agentic"}
)
C’est tout. Pas de surcoût : tarification standard Gemini API, sans frais supplémentaire pour la fonctionnalité. (Source primaire Google DeepMind)
Ce que ça débloque concrètement :
- Recherche dans du long contenu : trouver un passage précis dans 2 heures d’enregistrement sans envoyer 7 200 images. Webinaires, archives, réunions longues.
- Montage automatique précis : récupérer un instant à la demi-seconde, repérer un cut ou un changement d’état. Avant, 1 FPS faisait rater tout ce qui dure moins d’une seconde.
- Comptage d’actions et d’objets : suivre des mouvements répétitifs ou des objets distincts sur toute la durée d’une vidéo.
- Détection d’anomalies : re-scanner les passages suspects à plus haute fréquence d’images, sans ingérer la totalité.
L’angle YouTube qui mérite attention
Dans l’annonce, Google glisse que la même technologie va alimenter « Ask YouTube », une fonctionnalité prévue sur les pages de lecture de vidéos. Les spectateurs pourront poser des questions directes sur le contenu d’une vidéo, avec des réponses ancrées dans les visuels et non juste dans les métadonnées ou la description.
Pour un créateur qui mise sur YouTube, c’est une bifurcation à anticiper. L’utilisateur qui cherchait « à quel moment il parle de X dans la vidéo » aura une réponse immédiate sans naviguer manuellement dans le player. Bonne nouvelle pour l’engagement, question ouverte sur l’impact du temps de visionnage.
Ce que je retiens vraiment
Ce qui m’intéresse dans cette annonce, c’est surtout la confirmation d’un pattern : les LLMs cessent d’être des ingurgiteurs passifs pour devenir des chercheurs actifs. L’agentic vision pour les images existait déjà chez Google. Là, c’est la vidéo. La logique va s’étendre aux autres modalités : PDFs longs, bases de code, archives audio. Le modèle choisira quoi lire plutôt que de tout ingérer.
Pour les builders qui construisent sur de la vidéo : si tu paies des factures API pour analyser des enregistrements longs, tu n’as aucune raison de ne pas activer ce paramètre cette semaine. Les gains mesurés sont sur des benchmarks standard, pas des conditions de laboratoire exotiques.
Pour faire tourner ce type d’agent sur tes propres process, avec surveillance et alertes quand ça casse, voir mes prestations d’automatisation IA.